


反思机制
942 字
5 分钟
反思机制
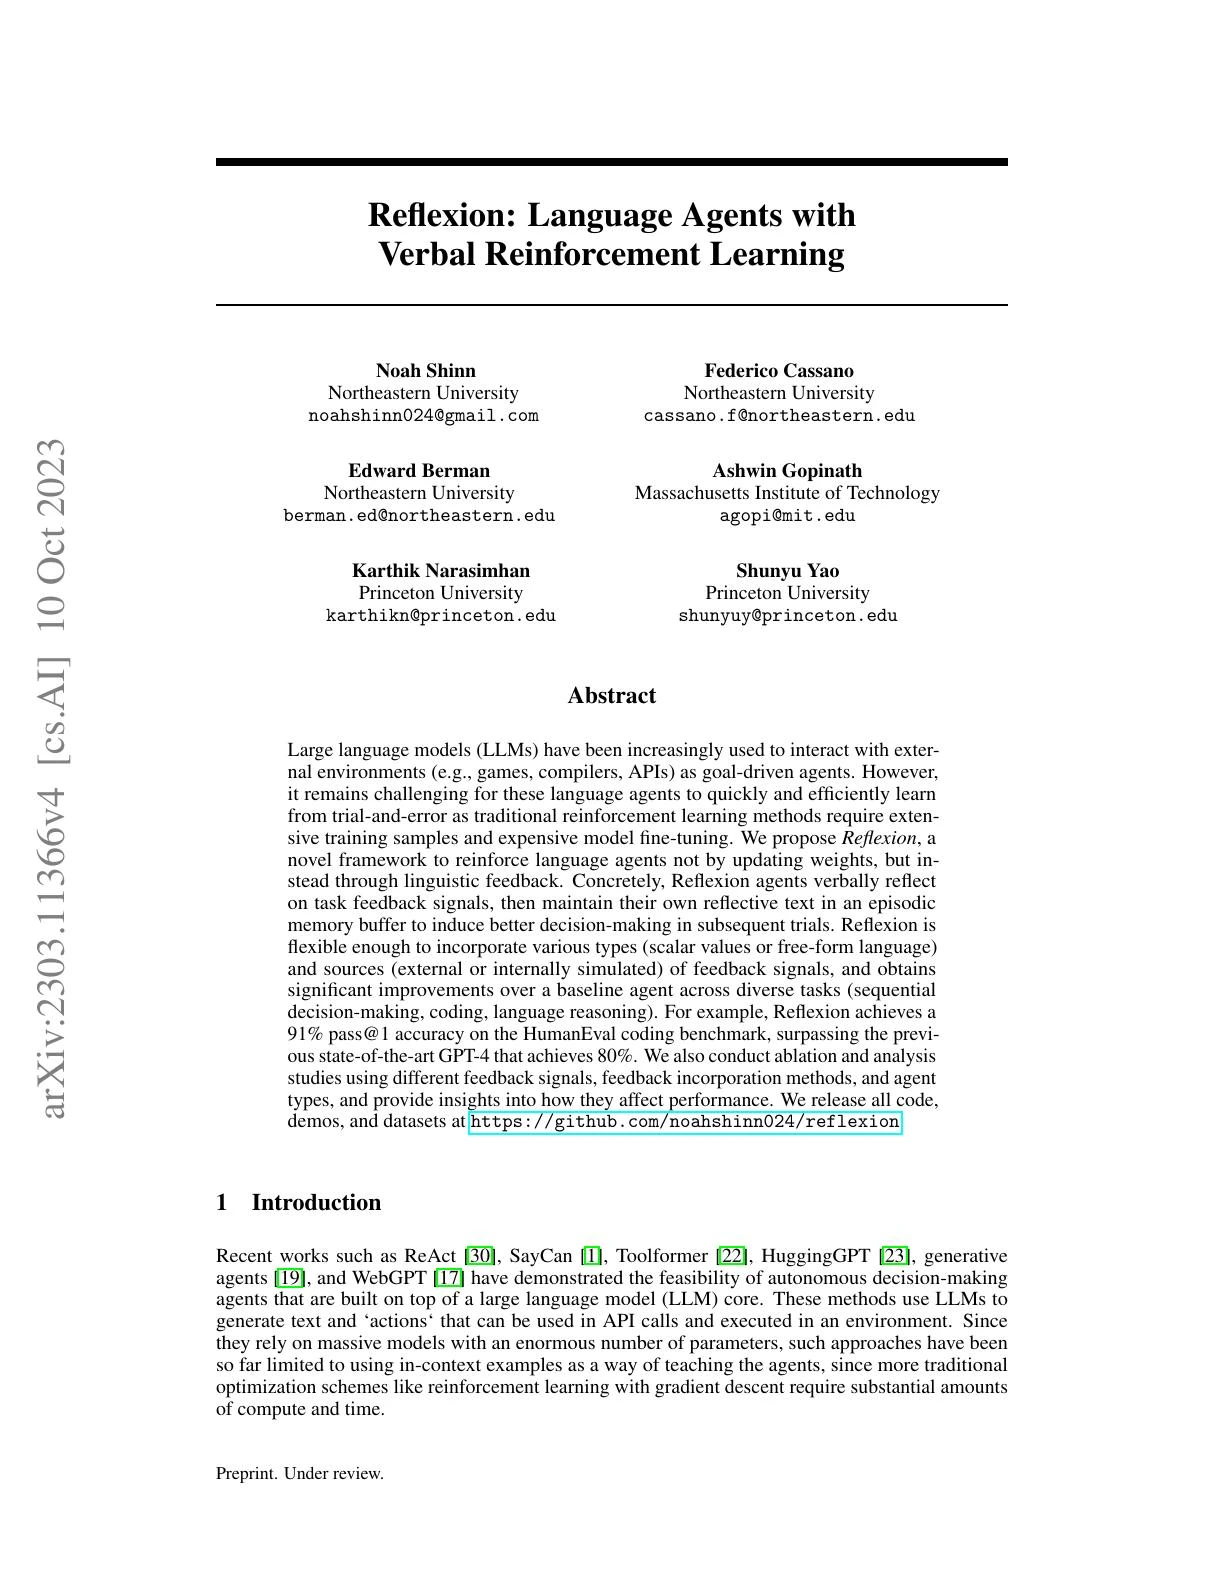
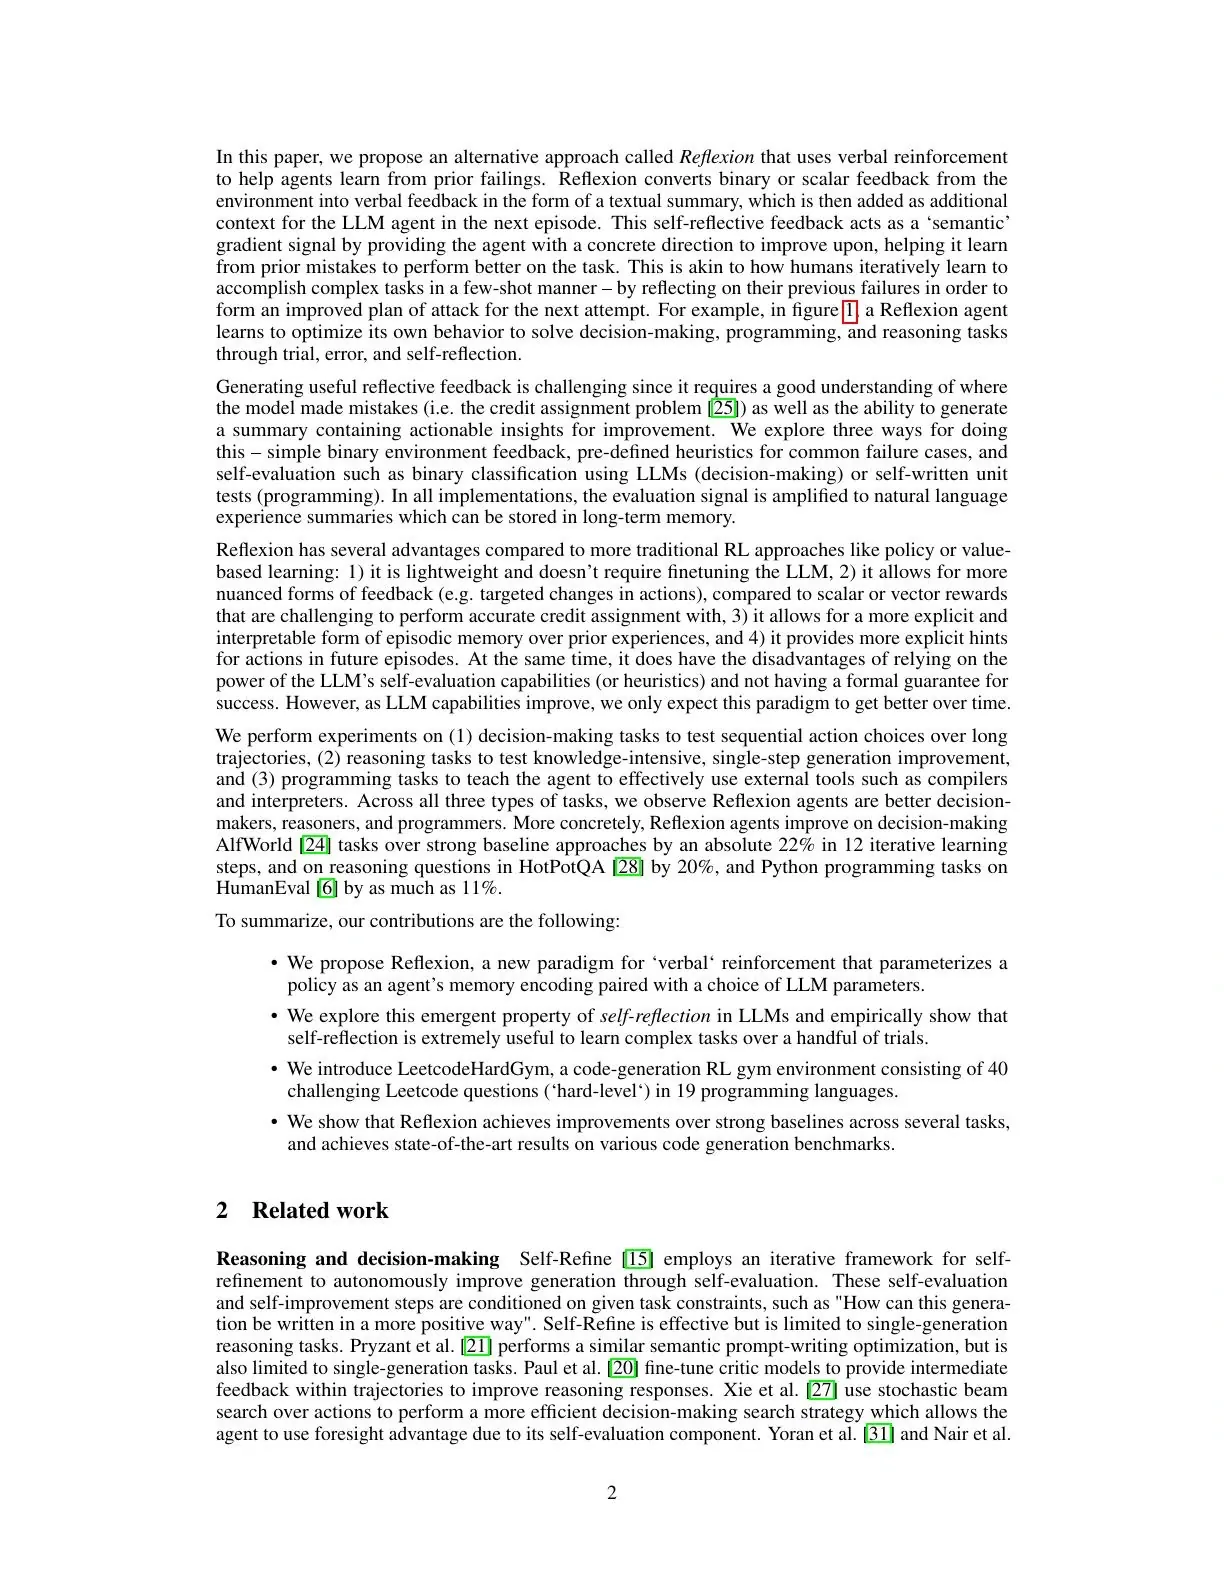
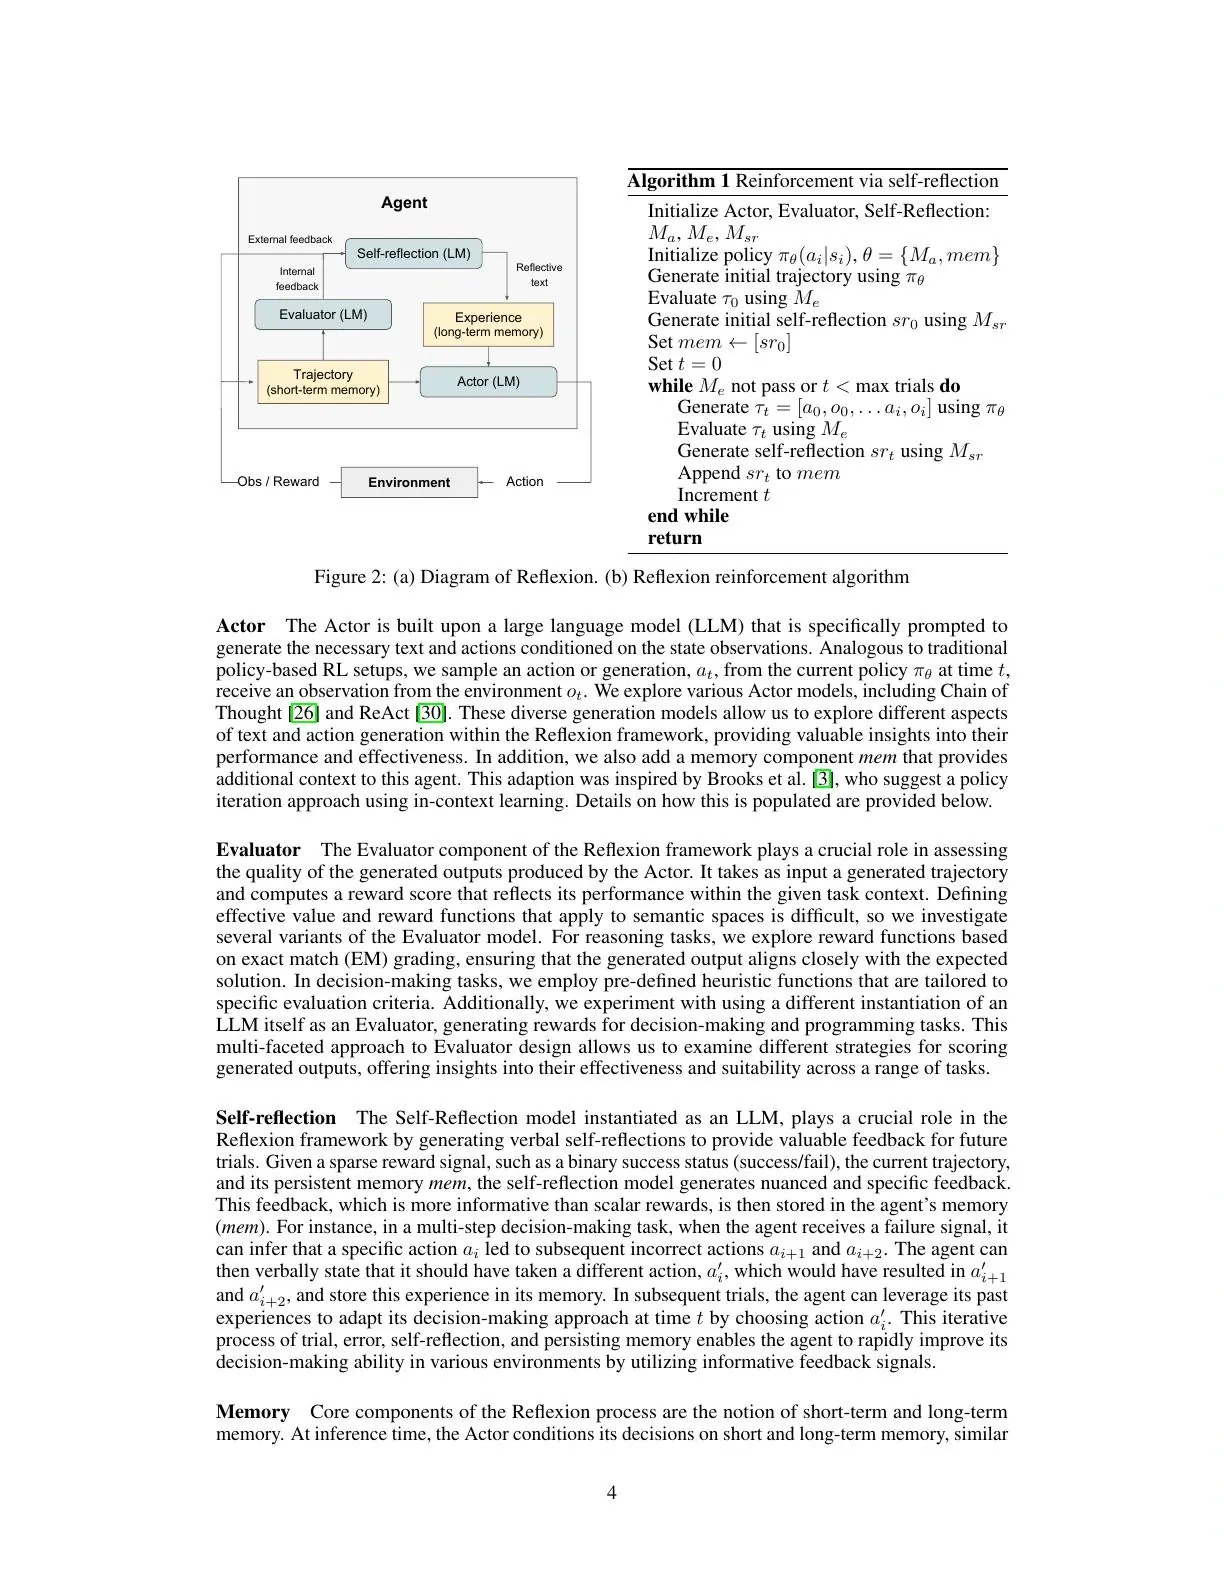
论文核心内容提炼:Reflexion: Language Agents with Verbal Reinforcement Learning
作者:Noah Shinn, Federico Cassano, Edward Berman, Ashwin Gopinath, Karthik Narasimhan, Shunyu Yao (Northeastern University, MIT, Princeton University)
发表:NeurIPS 2023 / arXiv 2023
1. 研究问题
- 语言智能体在编程、多步决策等复杂任务中通常通过 试错 改进。
- 传统强化学习需要大量样本和昂贵梯度更新,不适合基于 API 的大模型。
- 本文提出:能否让 LLM 在犯错后 自我反思并记住教训,下次主动避免?
2. 核心方法:Reflexion
基本思想(“错题本 + 写心得”)
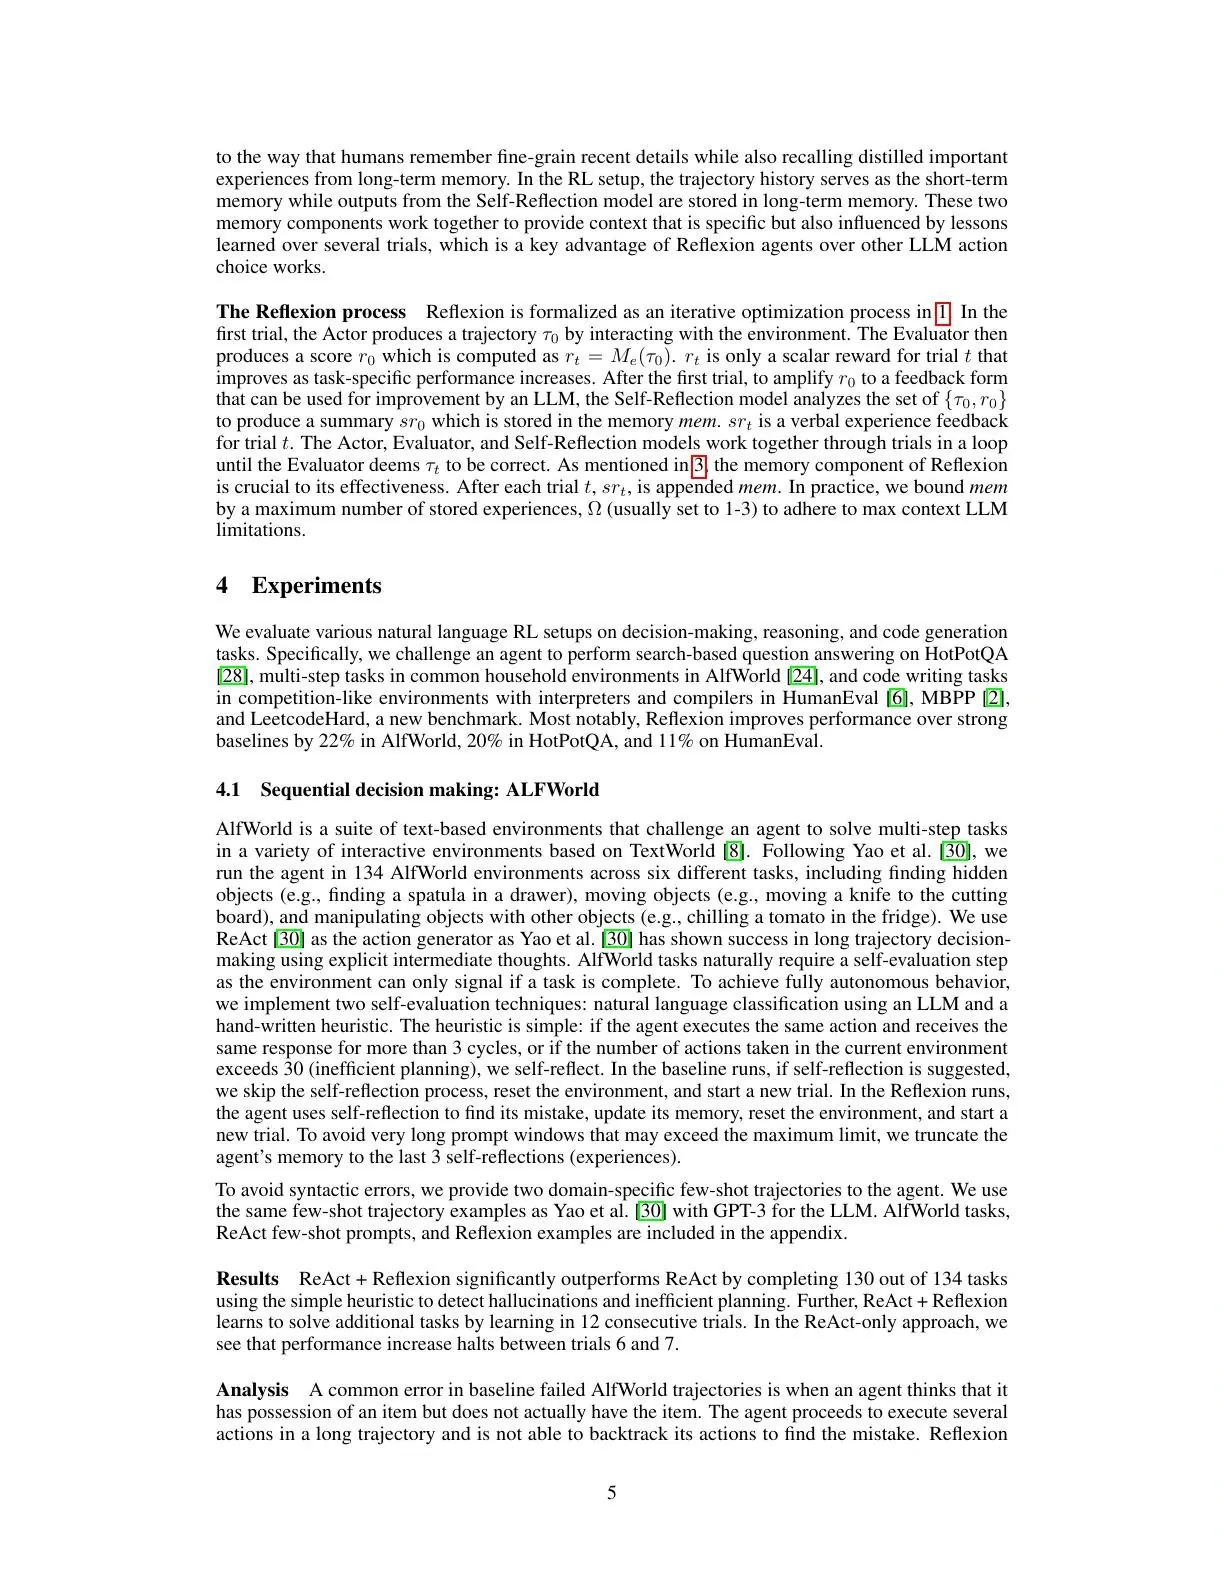
智能体不更新模型权重,而是把失败经验转为自然语言反思,存入长期记忆;下一轮将反思注入 prompt,带着教训重新尝试。
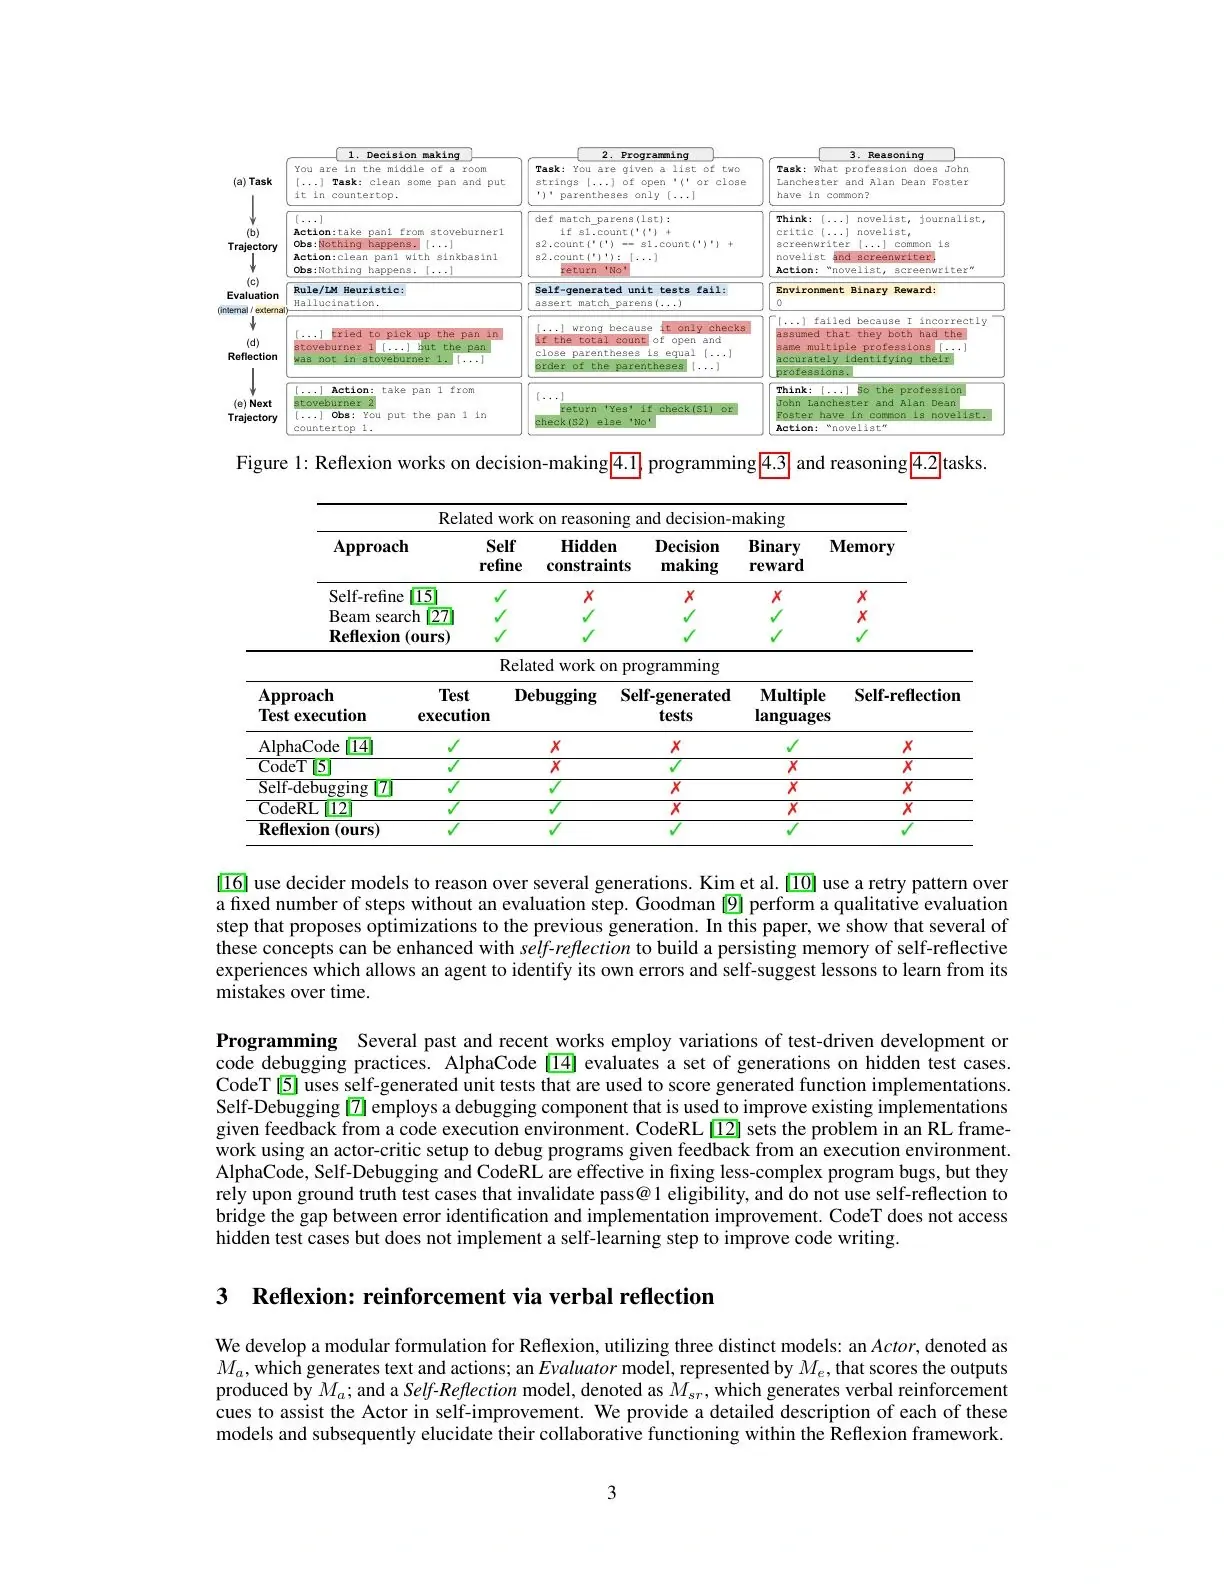
三大组件
| 组件 | 功能 | 实现方式 |
|---|---|---|
| 执行者(Actor) | 生成动作或答案 | CoT / ReAct 等基础 agent |
| 评估者(Evaluator) | 判断任务是否成功 | 环境反馈、单元测试、精确匹配 |
| 自我反思(Self-Reflection) | 将失败转化为语言经验 | LLM 生成改进建议 |
算法流程(每轮)
- Actor 尝试完成任务,生成轨迹。
- Evaluator 给出奖励。
- 失败时生成反思并存入记忆。
- 下一轮 Actor 将记忆注入 prompt。
3. 三组实验与结果
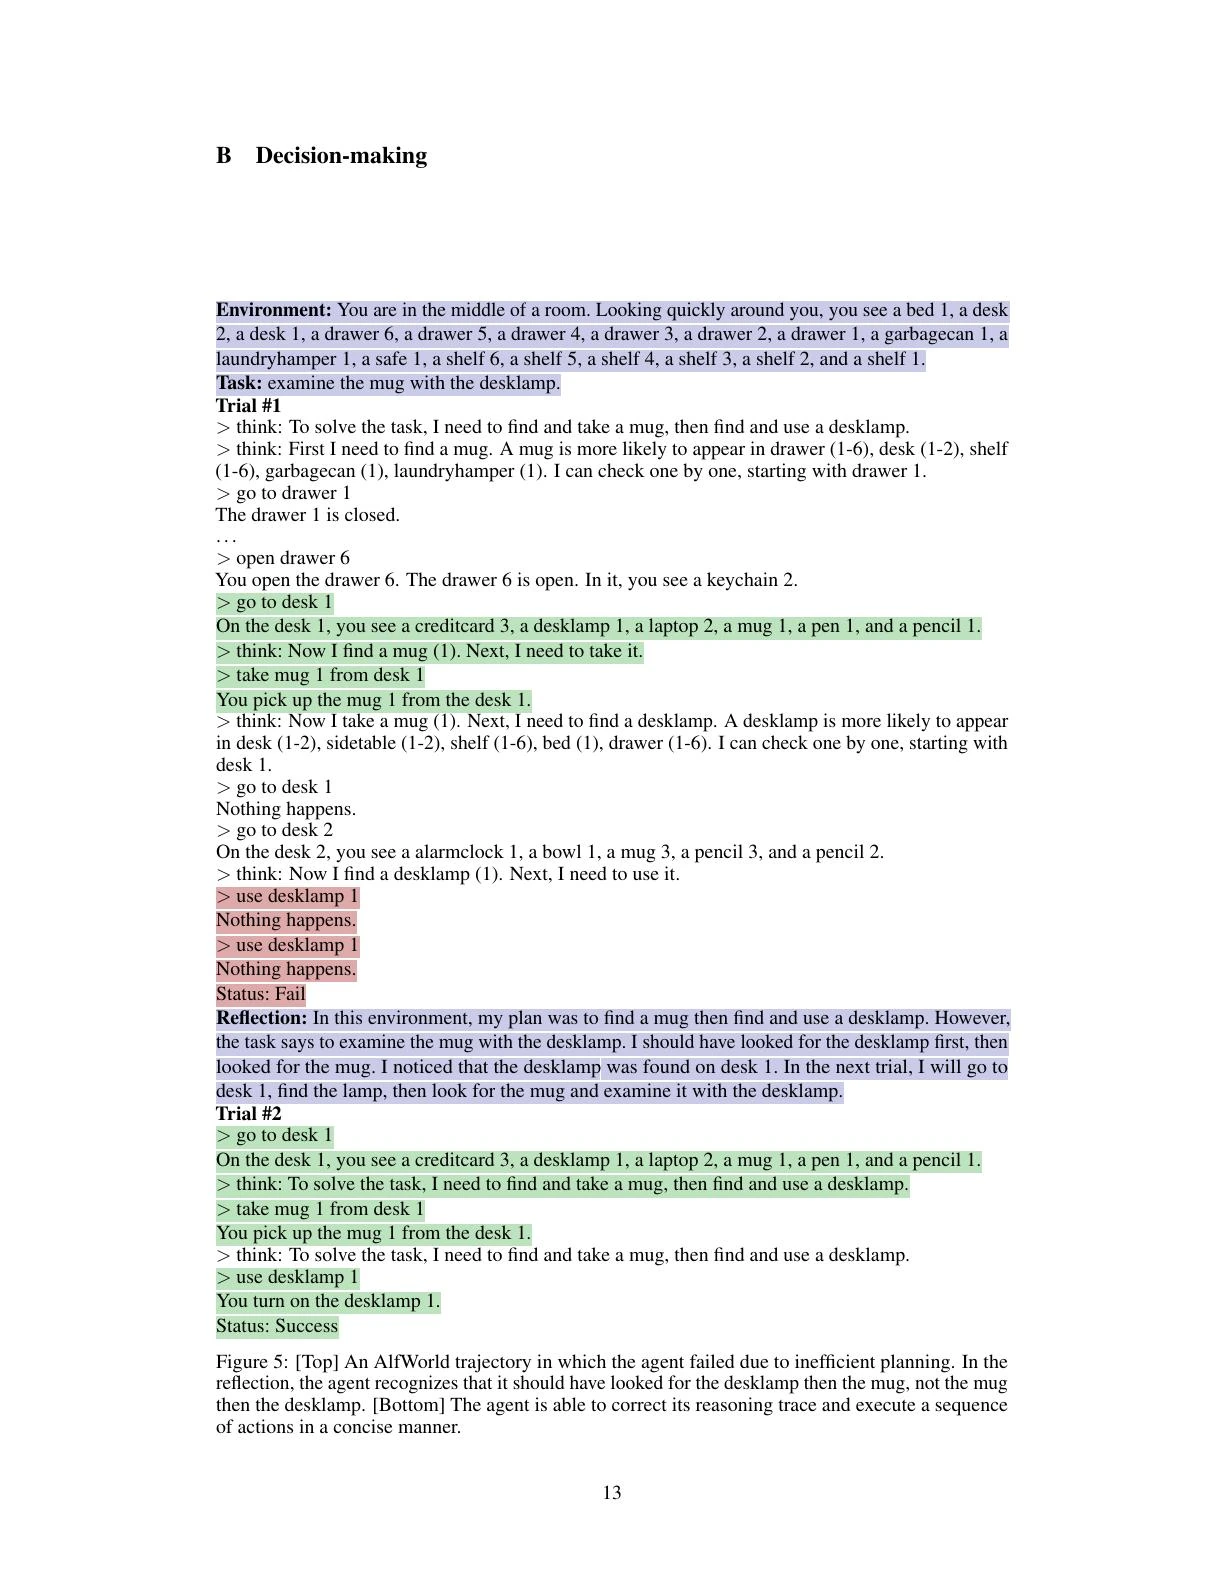
3.1 序列决策(ALFWorld)
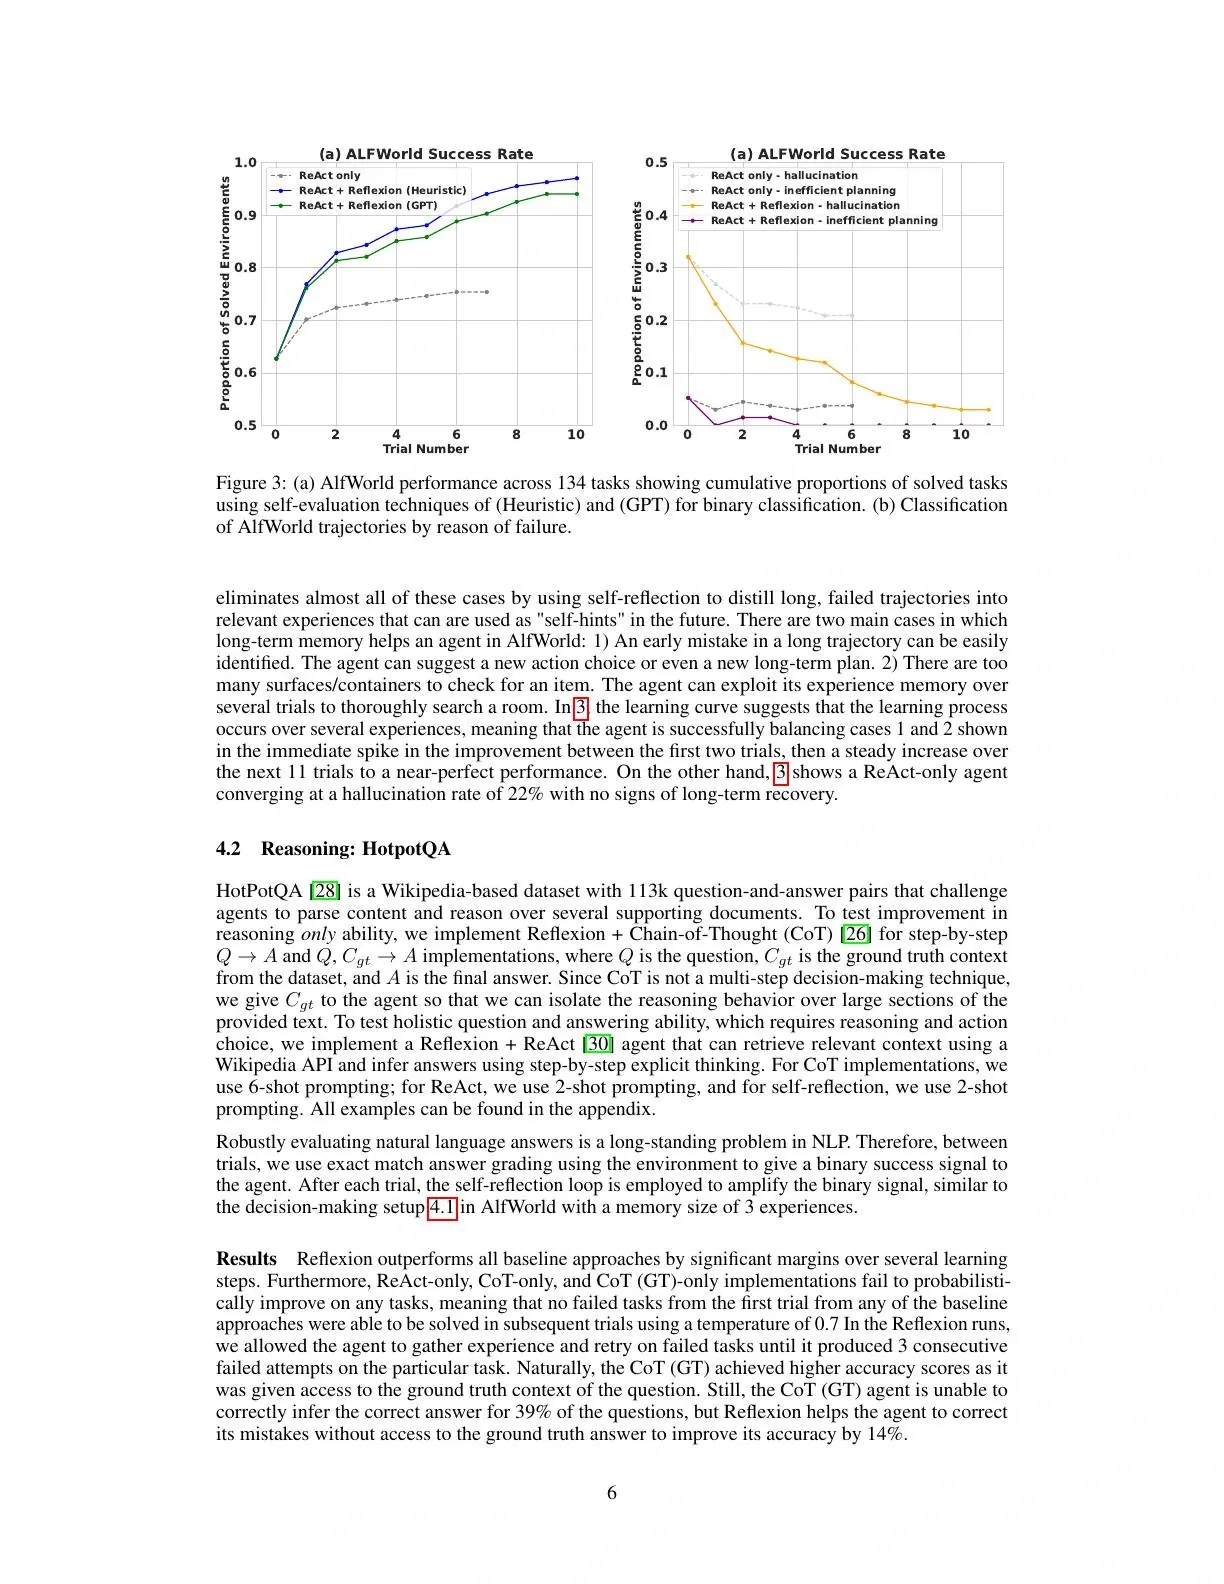
ReAct 约完成 64%; ReAct + Reflexion 完成 130/134(97%),绝对提升 22%。
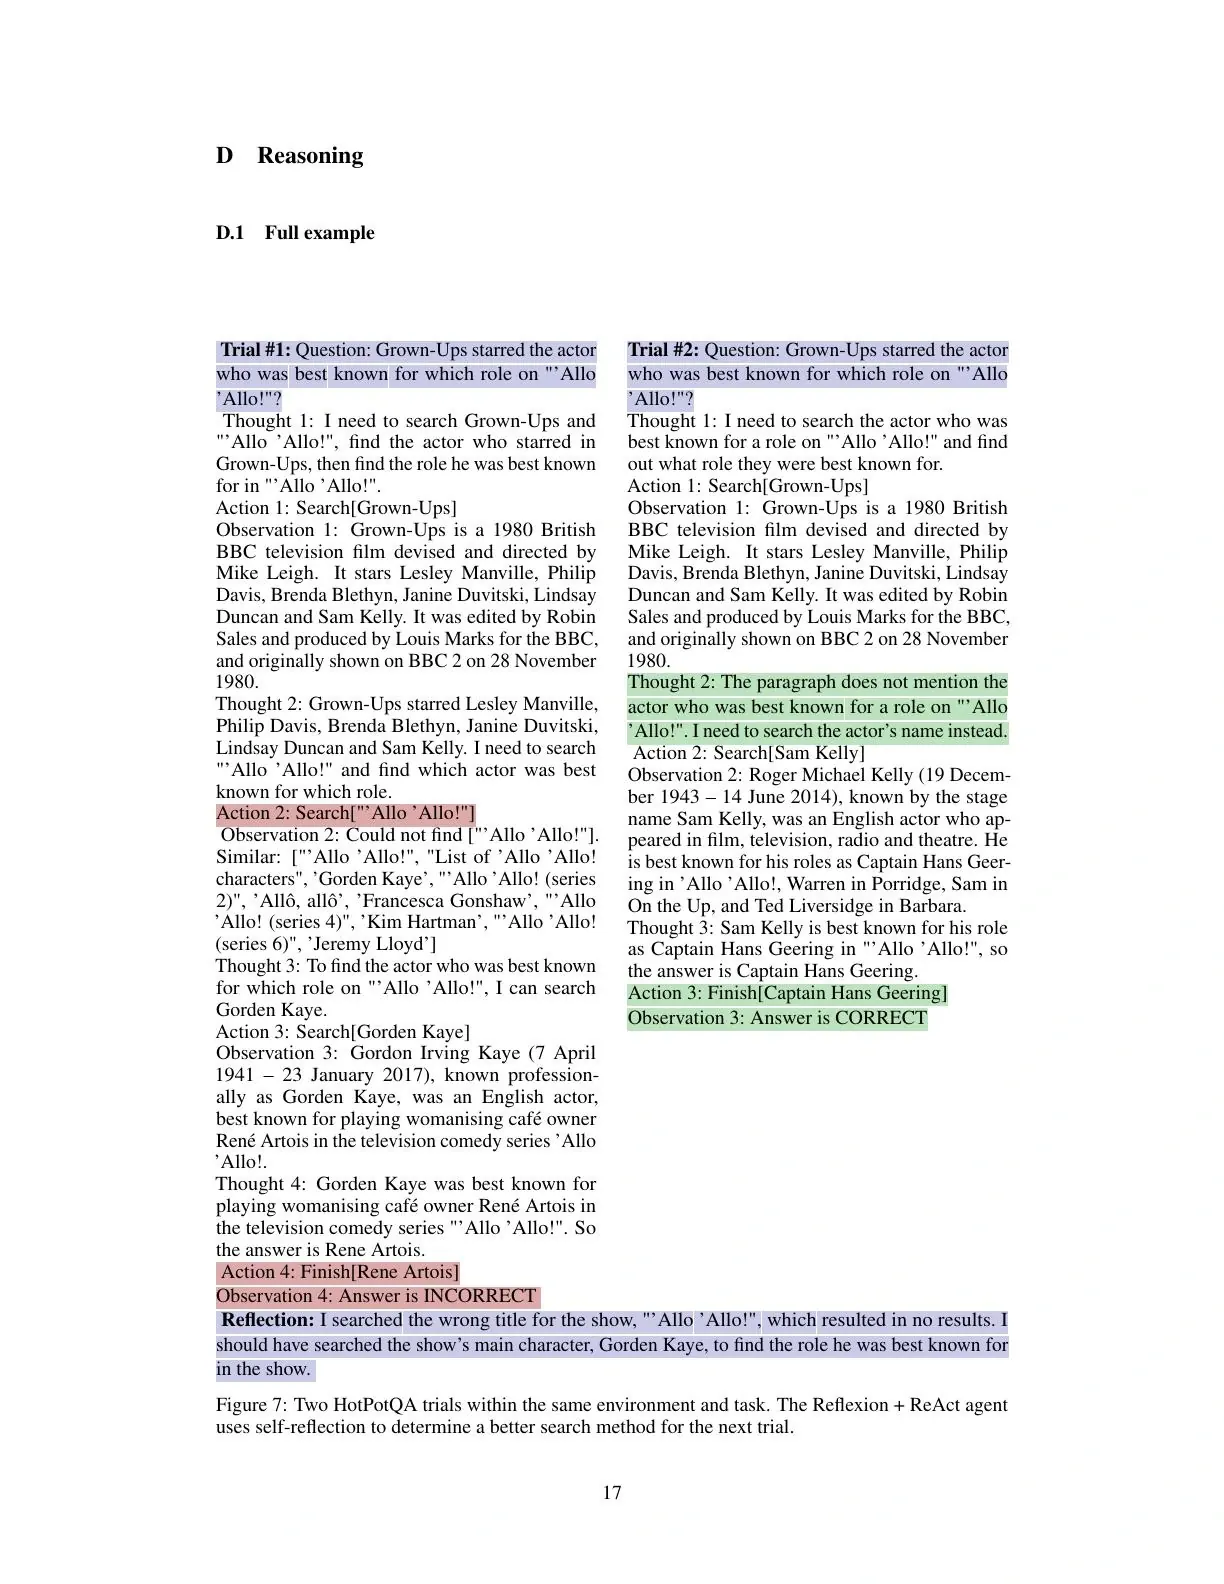
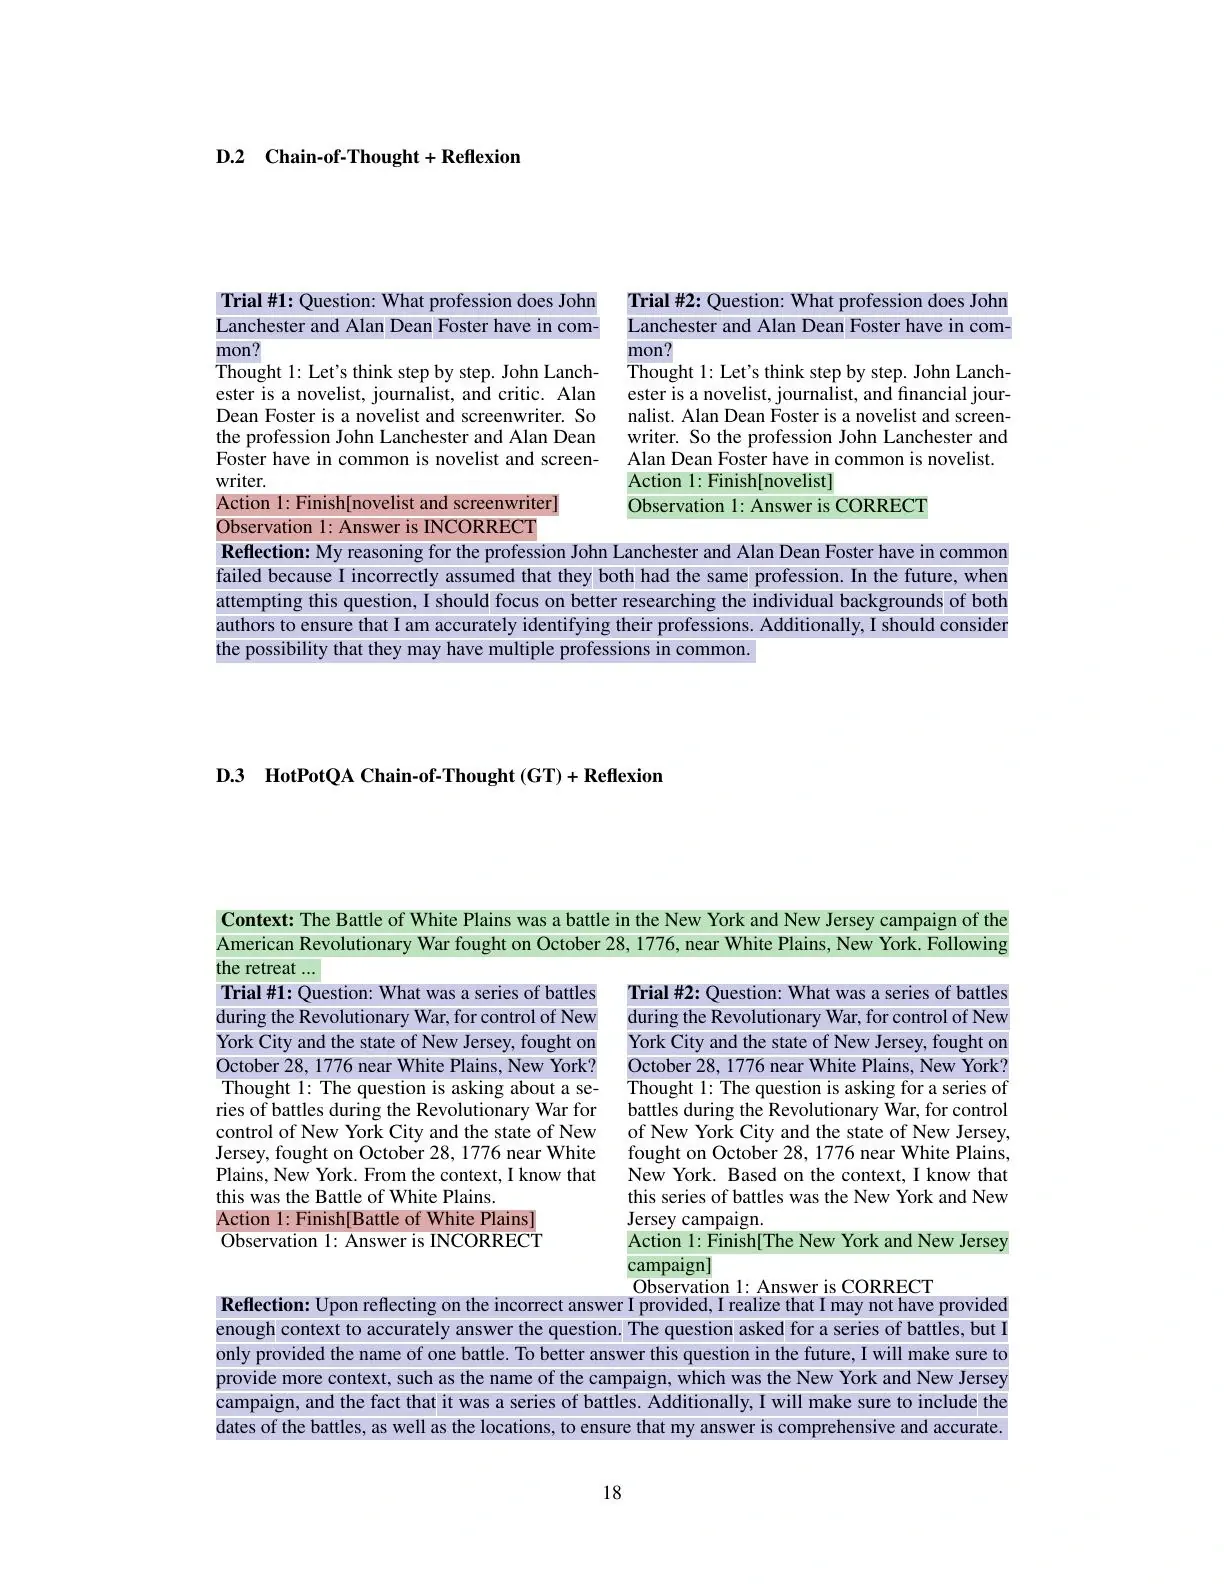
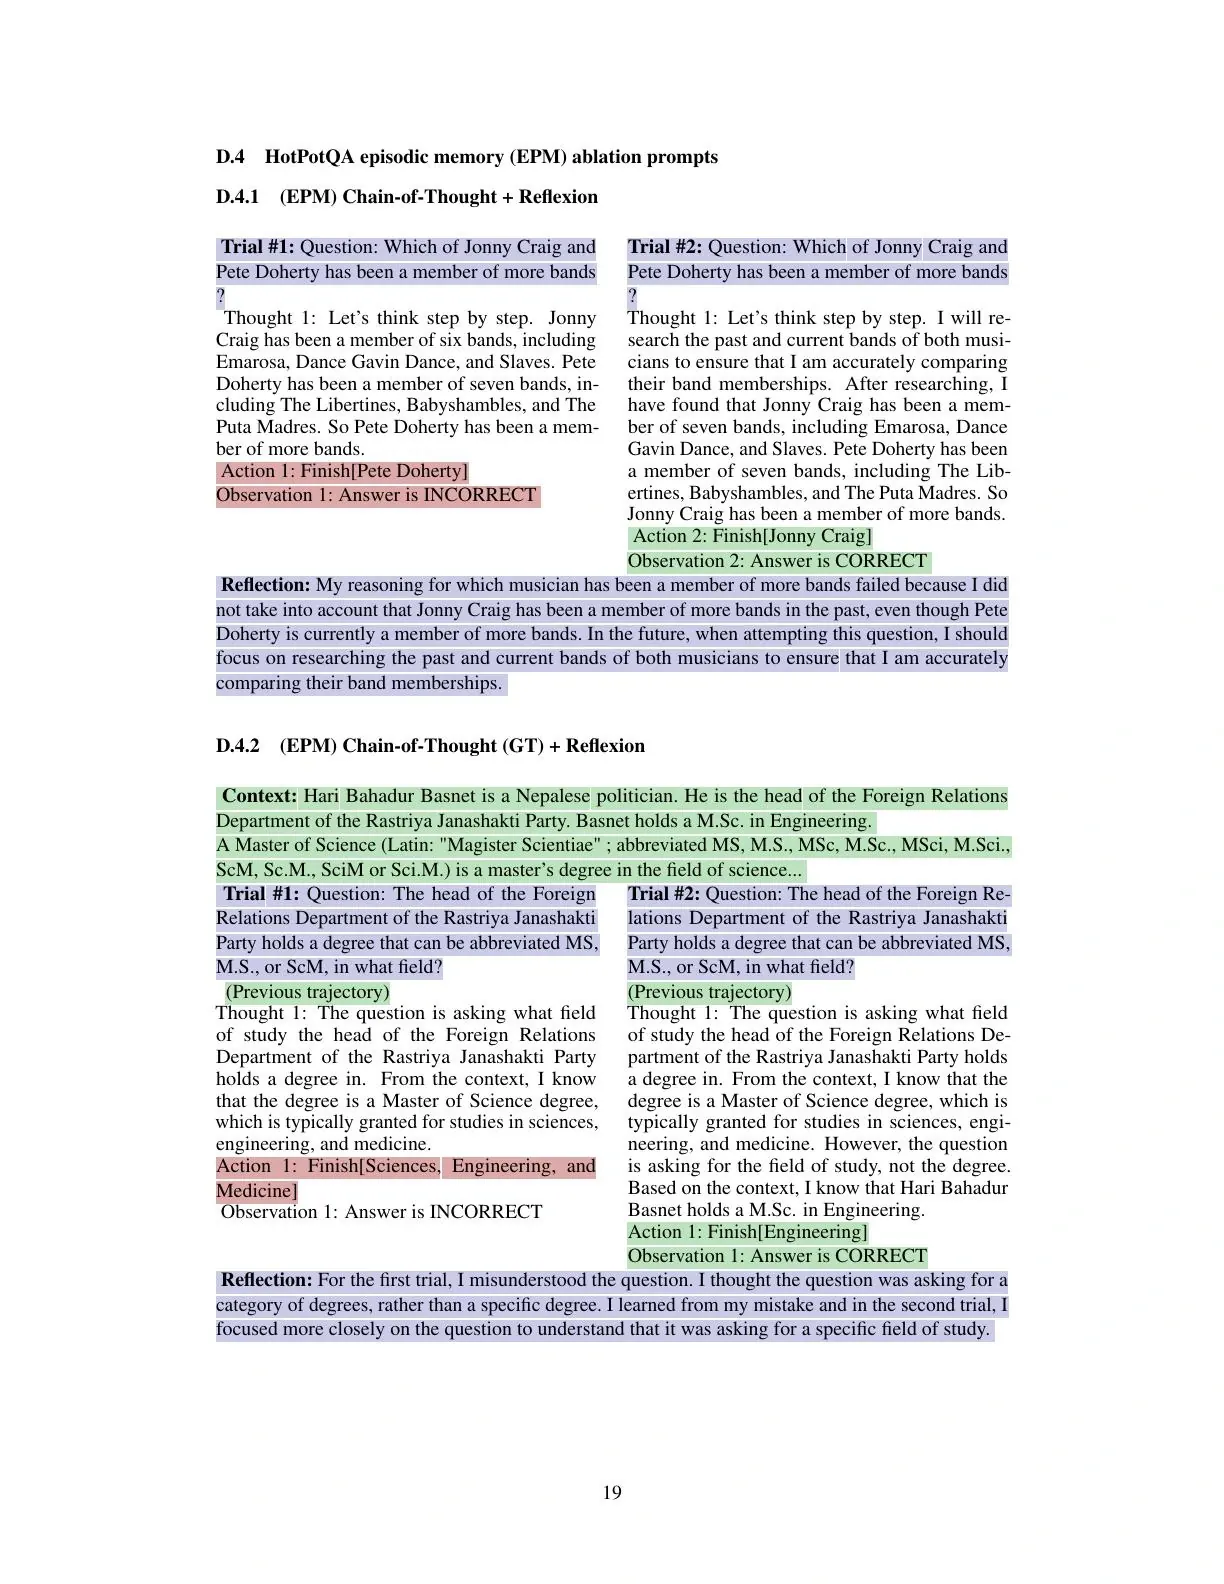
3.2 推理(HotPotQA)
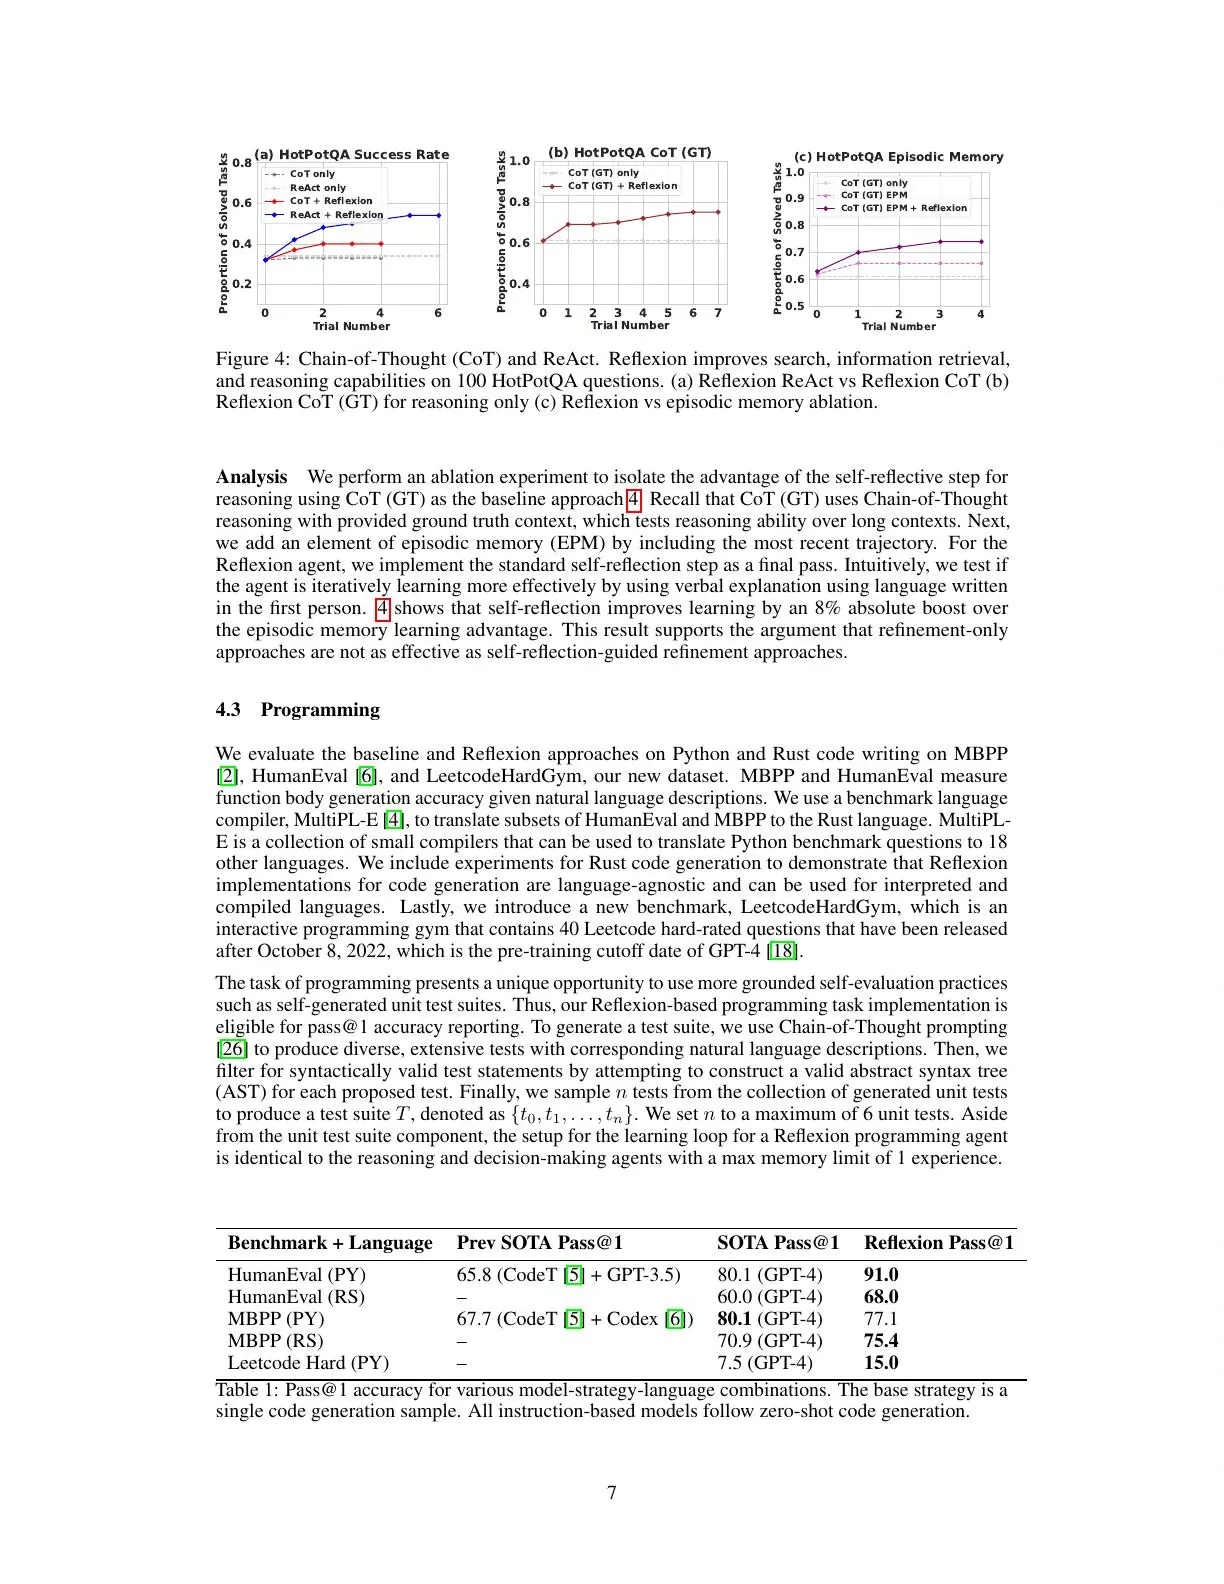
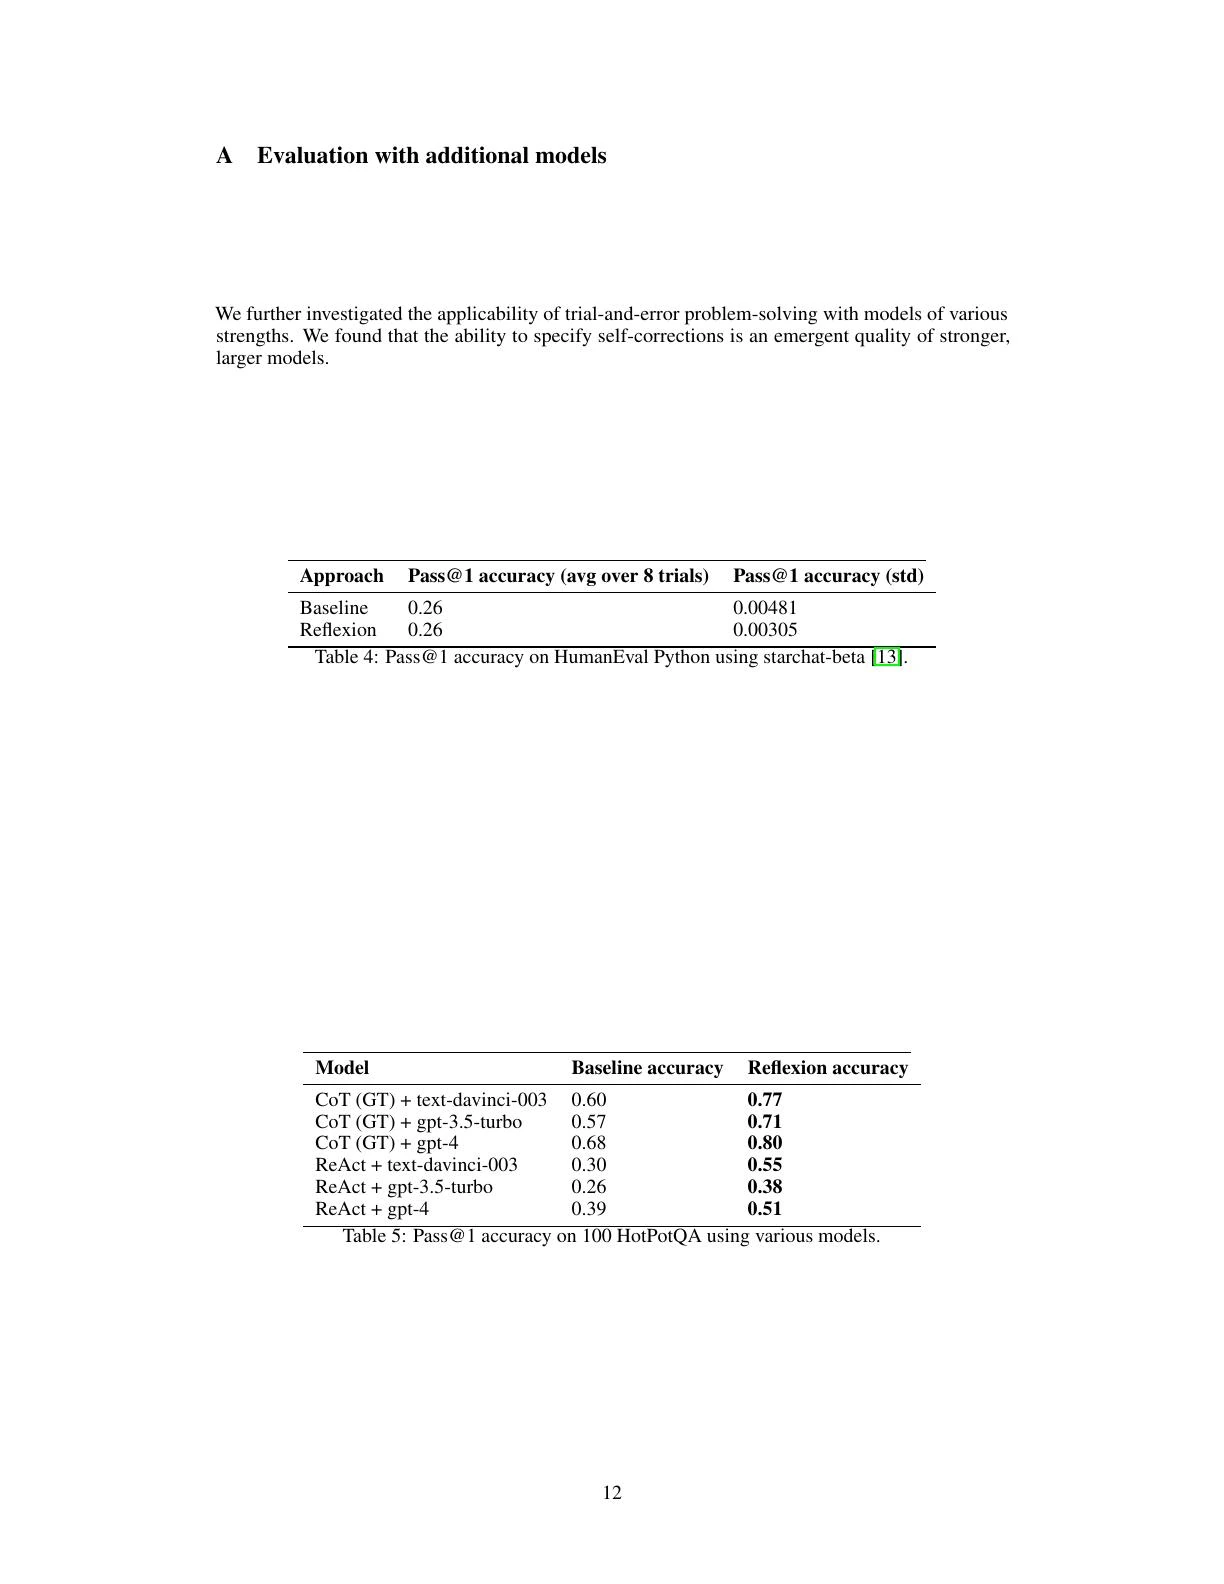
CoT 从 68% 提升至 80%,ReAct 从 39% 提升至 51%,均提升 12%。加入自我反思后额外增益 8%。
3.3 编程
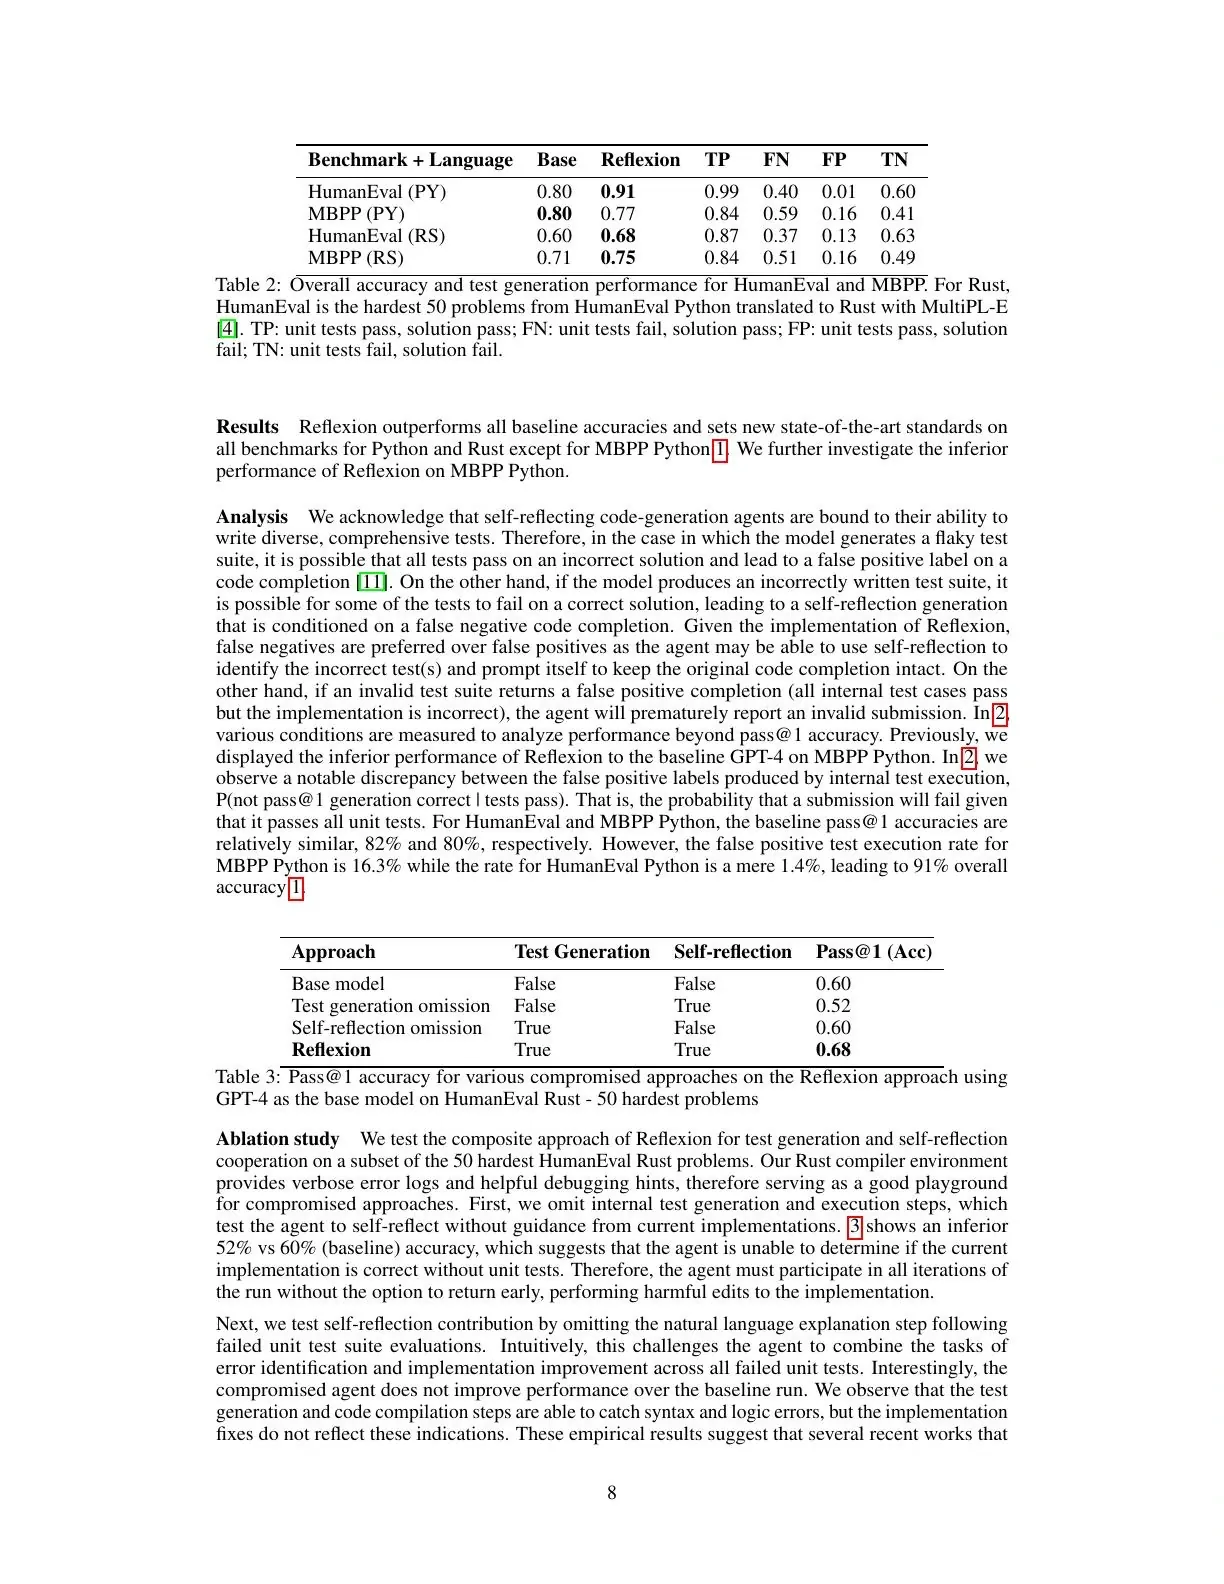
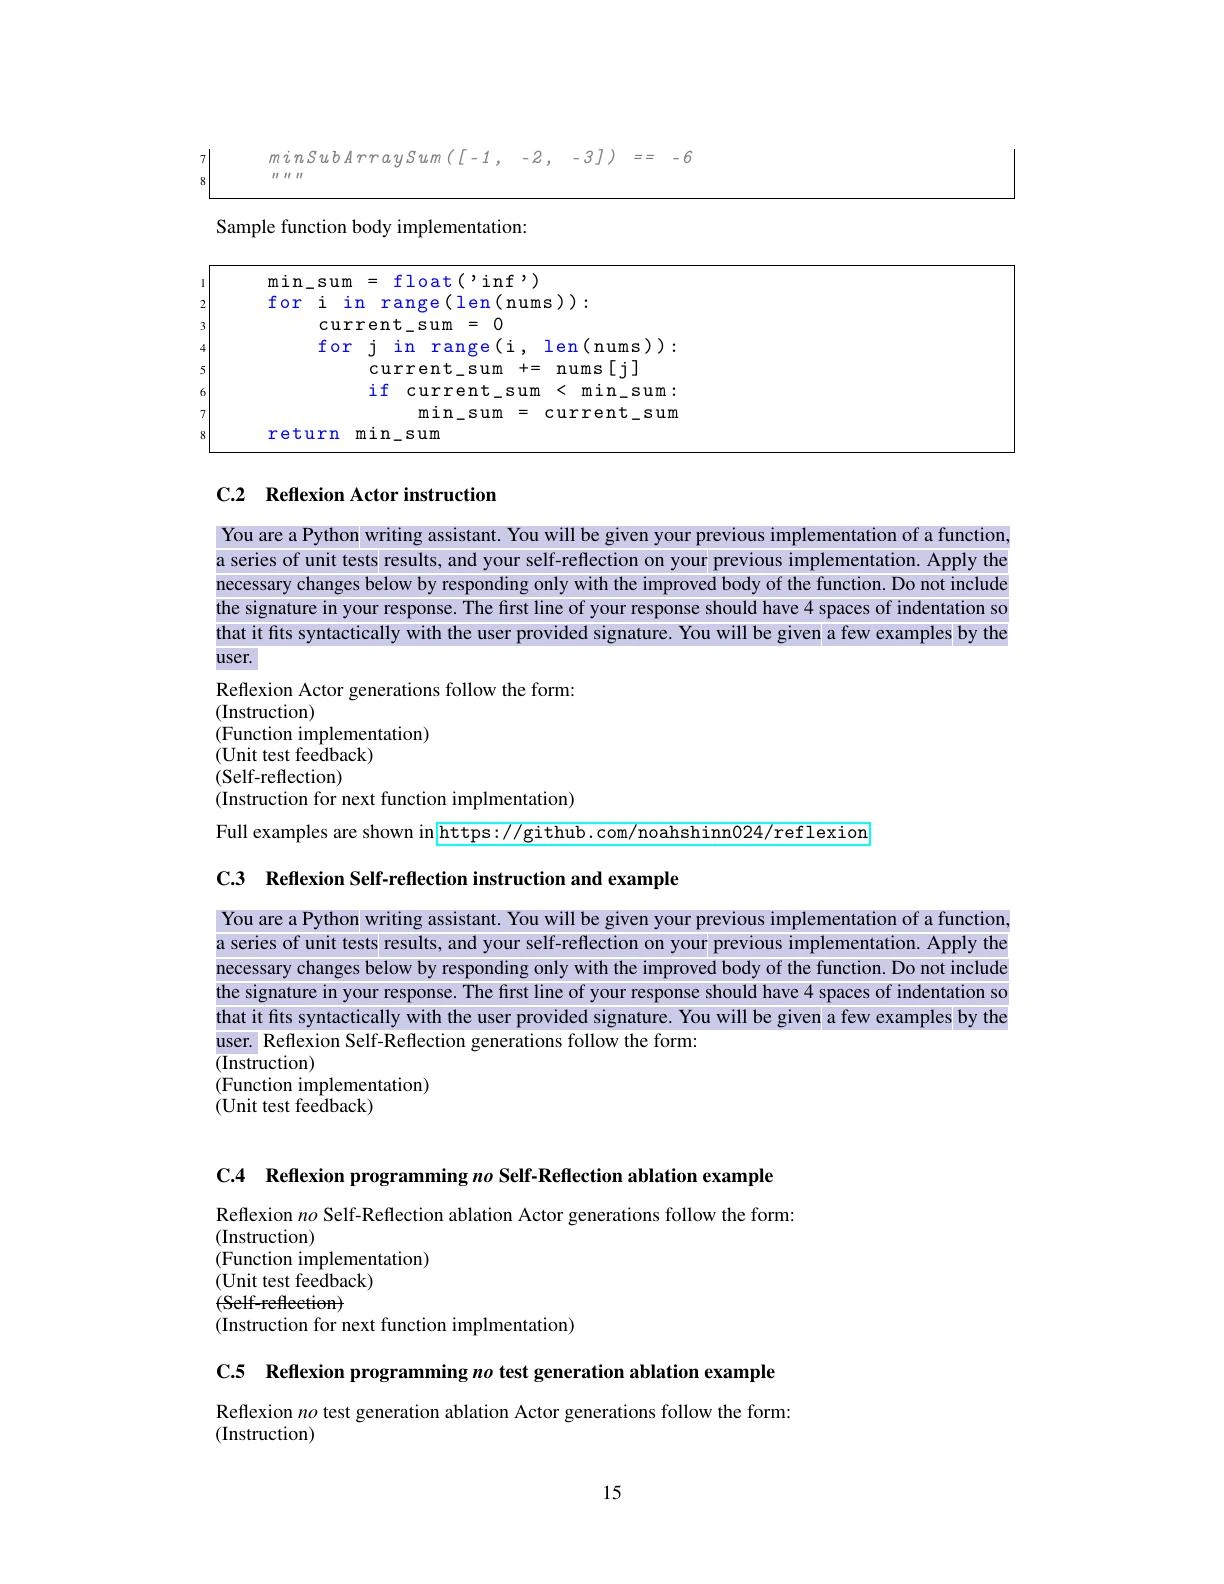
HumanEval Python 达到 91.0% pass@1,MBPP 77.1%,HumanEval Rust 68.0%,Leetcode Hard Python 15.0%。单元测试和反思缺一不可。
4. 与其他方法的对比
| 方法 | 是否需要微调 | 记忆机制 | 反馈形式 |
|---|---|---|---|
| Self-Refine | 否 | 单轮 refinement | 修改建议 |
| CoT-SC | 否 | 无 | 最终答案投票 |
| Reflexion | 否 | 长期记忆 + 反思 | 反思文本 |
Reflexion 把失败经验总结为自然语言并跨轮持久存储,使智能体快速收敛。
5. 优点与局限性
- 无需梯度更新:适合 API-only 模型。
- 样本效率高:通常 3~12 轮即可显著提升。
- 可解释性强:反思文本人类可读。
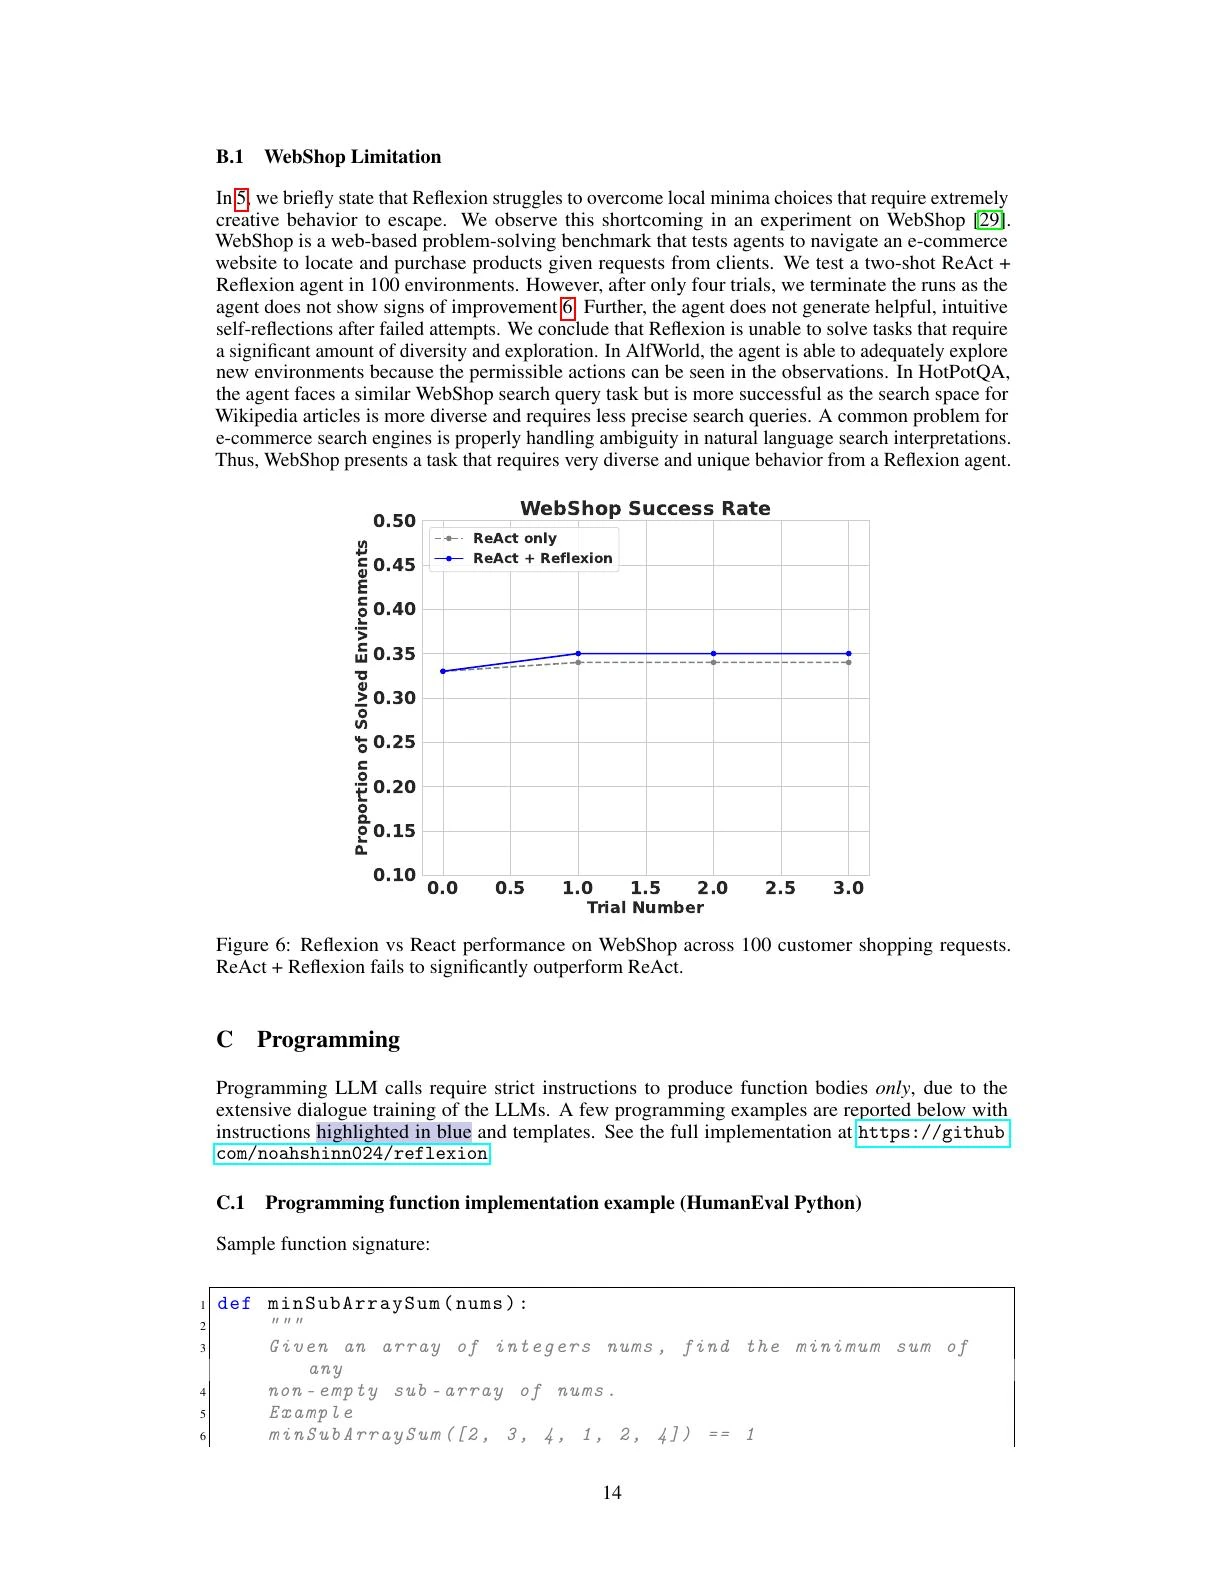
- 依赖模型自我评估能力:错误判断可能产生误导性反思。
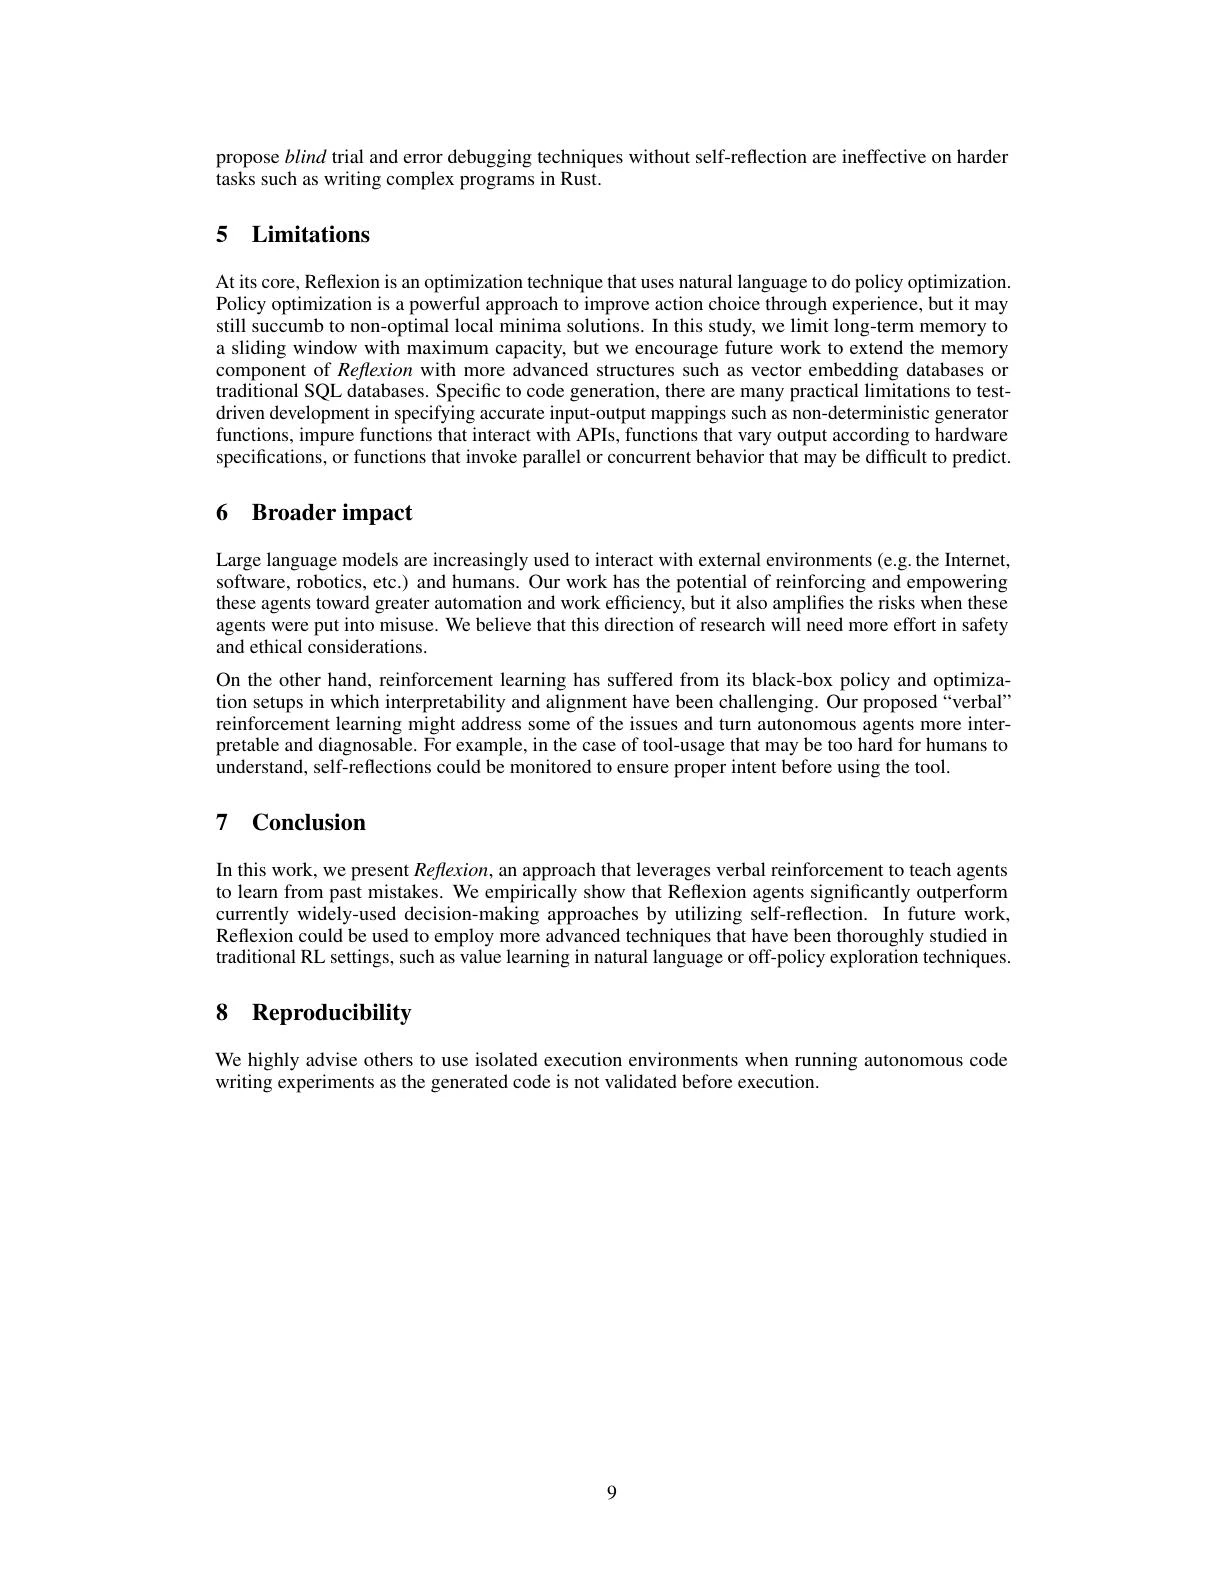
- 记忆容量受限:上下文长度限制可保留经验数量。
- 可能陷入局部最优,并依赖单元测试质量。
6. 核心贡献总结
- 首次提出 言语强化学习(Verbal Reinforcement Learning),用自然语言反馈替代梯度信号。
- 设计 Actor-Evaluator-Self-Reflection 三模块框架,并用长期记忆存储经验。
- HumanEval 达到 91% pass@1,超越当时公开模型(包括 GPT-4)。
- 为低成本、高样本效率、可解释的语言智能体提供了新范式。
原论文在线预览
文章分享
如果这篇文章对你有帮助,欢迎分享给更多人!
反思机制
https://www.shanfengpm.com/posts/2026-03-03-paper-reflexion/本文首发于「山风blog」,作者:山风(余涛)。欢迎转发、分享本文链接, 但禁止任何形式的未授权转载、摘编、改写或商业使用。

推荐文章论文阅读