


CoT思维链
1752 字
9 分钟
CoT思维链
论文核心内容提炼:Chain-of-Thought Prompting Elicits Reasoning in Large Language Models
作者:Jason Wei, Xuezhi Wang, Dale Schuurmans, Maarten Bosma, Brian Ichter, Fei Xia, Ed H. Chi, Quoc V. Le, Denny Zhou (Google Research)
发表:NeurIPS 2022
1. 研究问题
- 大语言模型在直接输出答案时,在 多步推理任务 (如算术、常识推理)上表现不佳。
- 即便增加模型规模,性能提升也很有限。
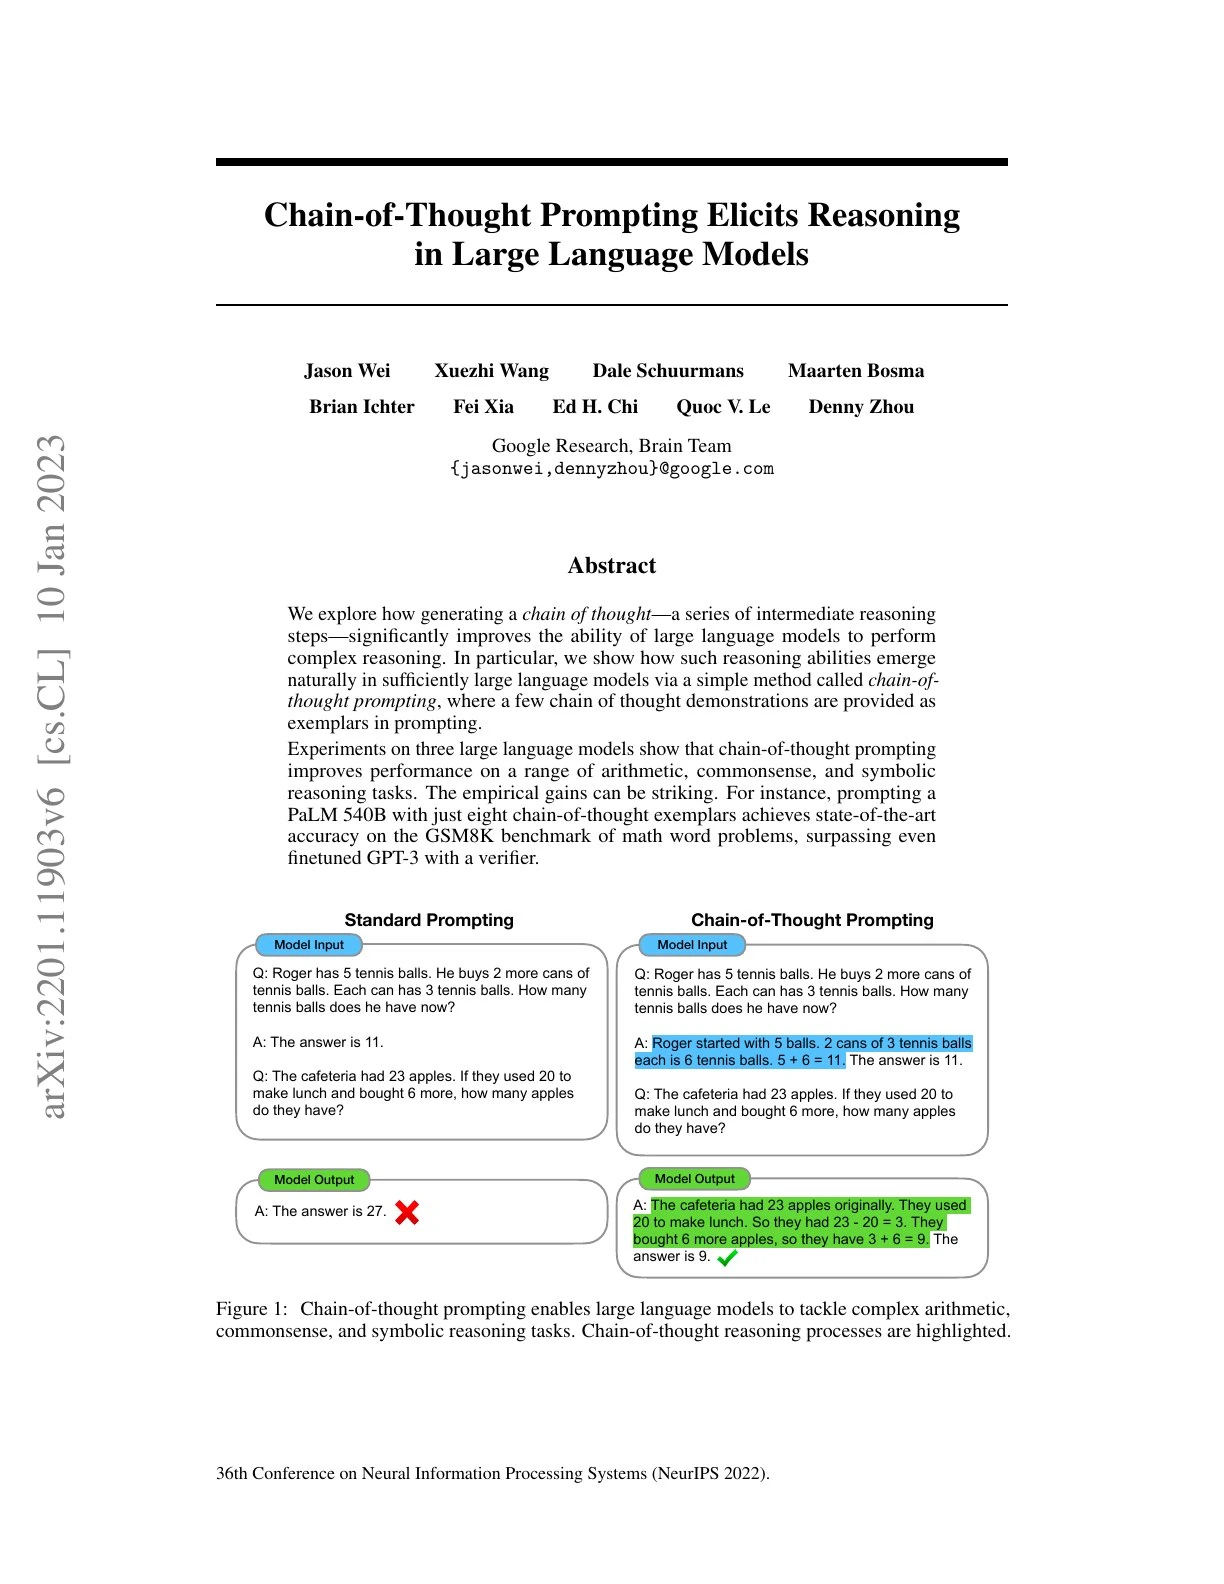
- 本文提出:如果能让模型 在输出答案之前,先生成中间推理步骤,是否能显著提升推理能力?
2. 核心方法:思维链提示(Chain-of-Thought Prompting)
基本思想
- 在 few-shot 示例中,不仅给出(问题,答案),还给出 一步步的推理过程。
- 例如:
Q: 停车场有3辆车,又来了2辆,现在有几辆? A: 已有3辆 + 新来2辆 = 5辆。答案是5。
形式
- 标准 prompt:
[问题] → [答案] - CoT prompt:
[问题] → [推理步骤1] → [推理步骤2] → ... → [答案]
关键属性
- 分解复杂问题:将多步问题拆解为多个简单子问题。
- 可解释性:展示模型如何得到答案,便于调试。
- 适用于任何语言可描述的任务:不限于数学,可推广到常识、符号推理等。
- 仅需 few-shot 示例:无需微调,直接用于现成模型。
3. 实验设计与主要结果
评测任务
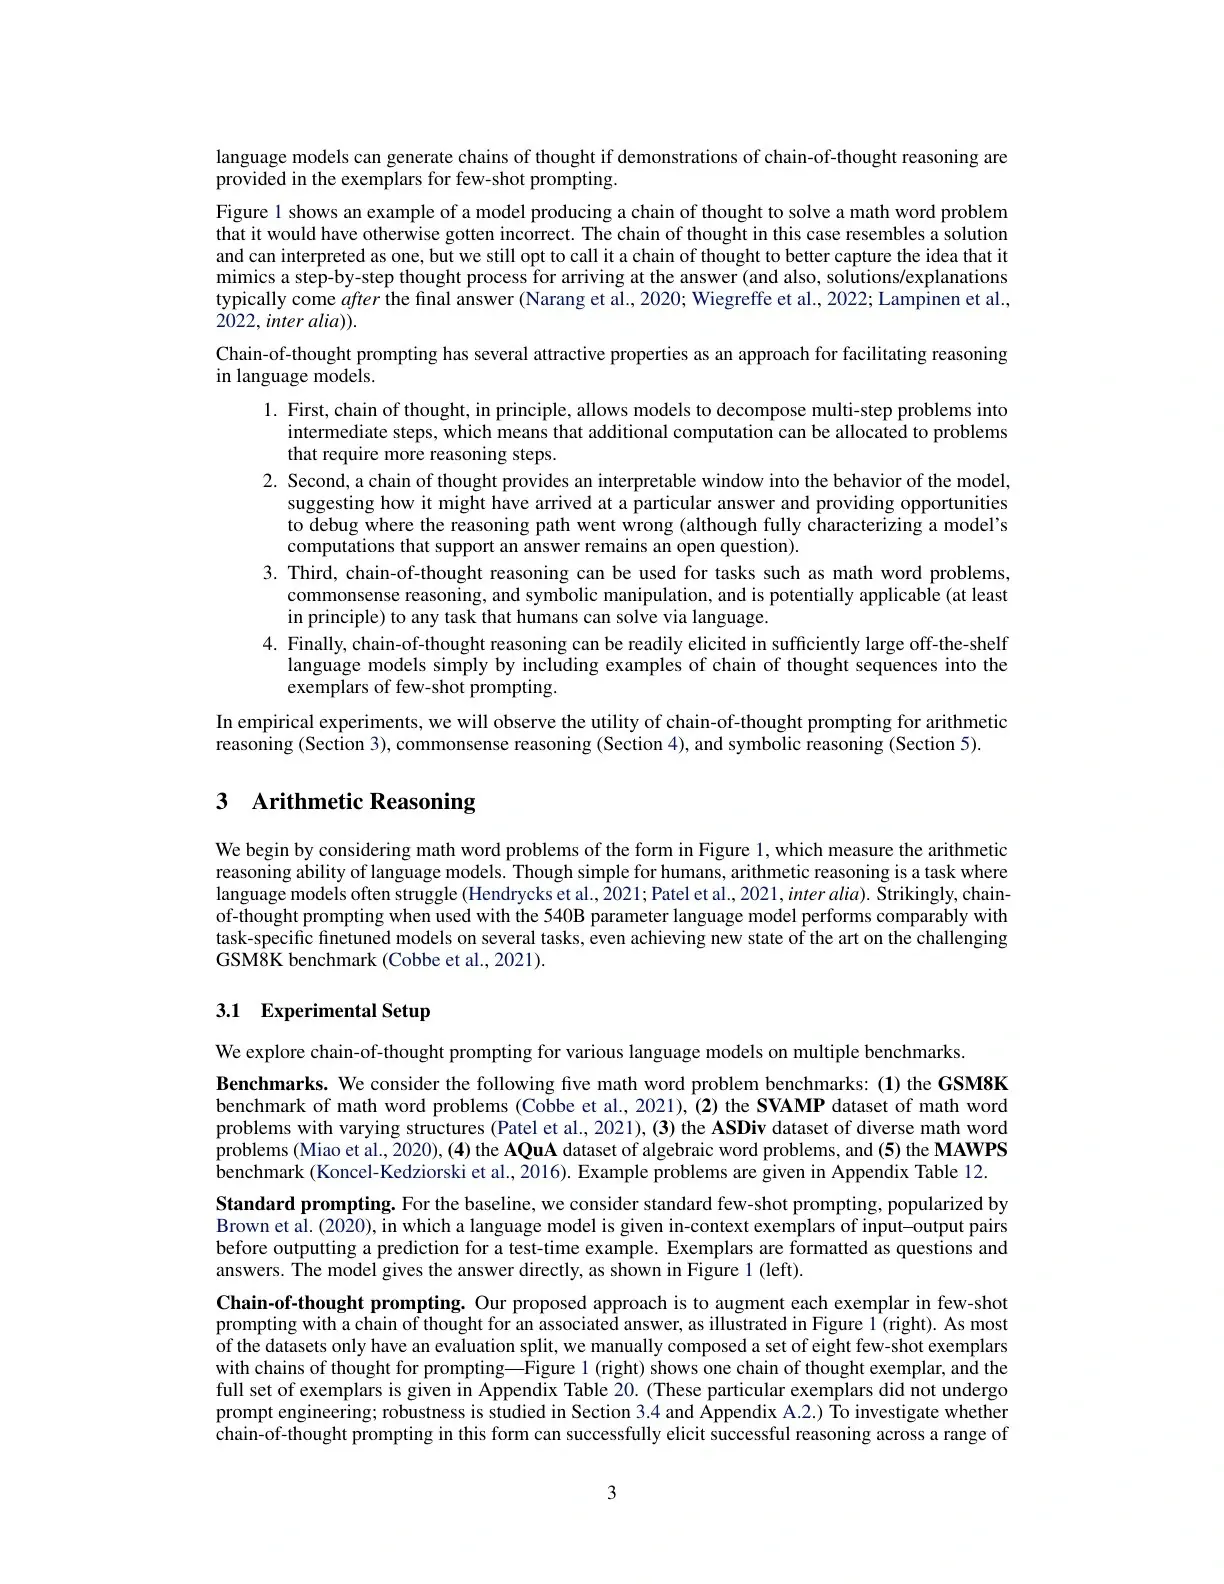
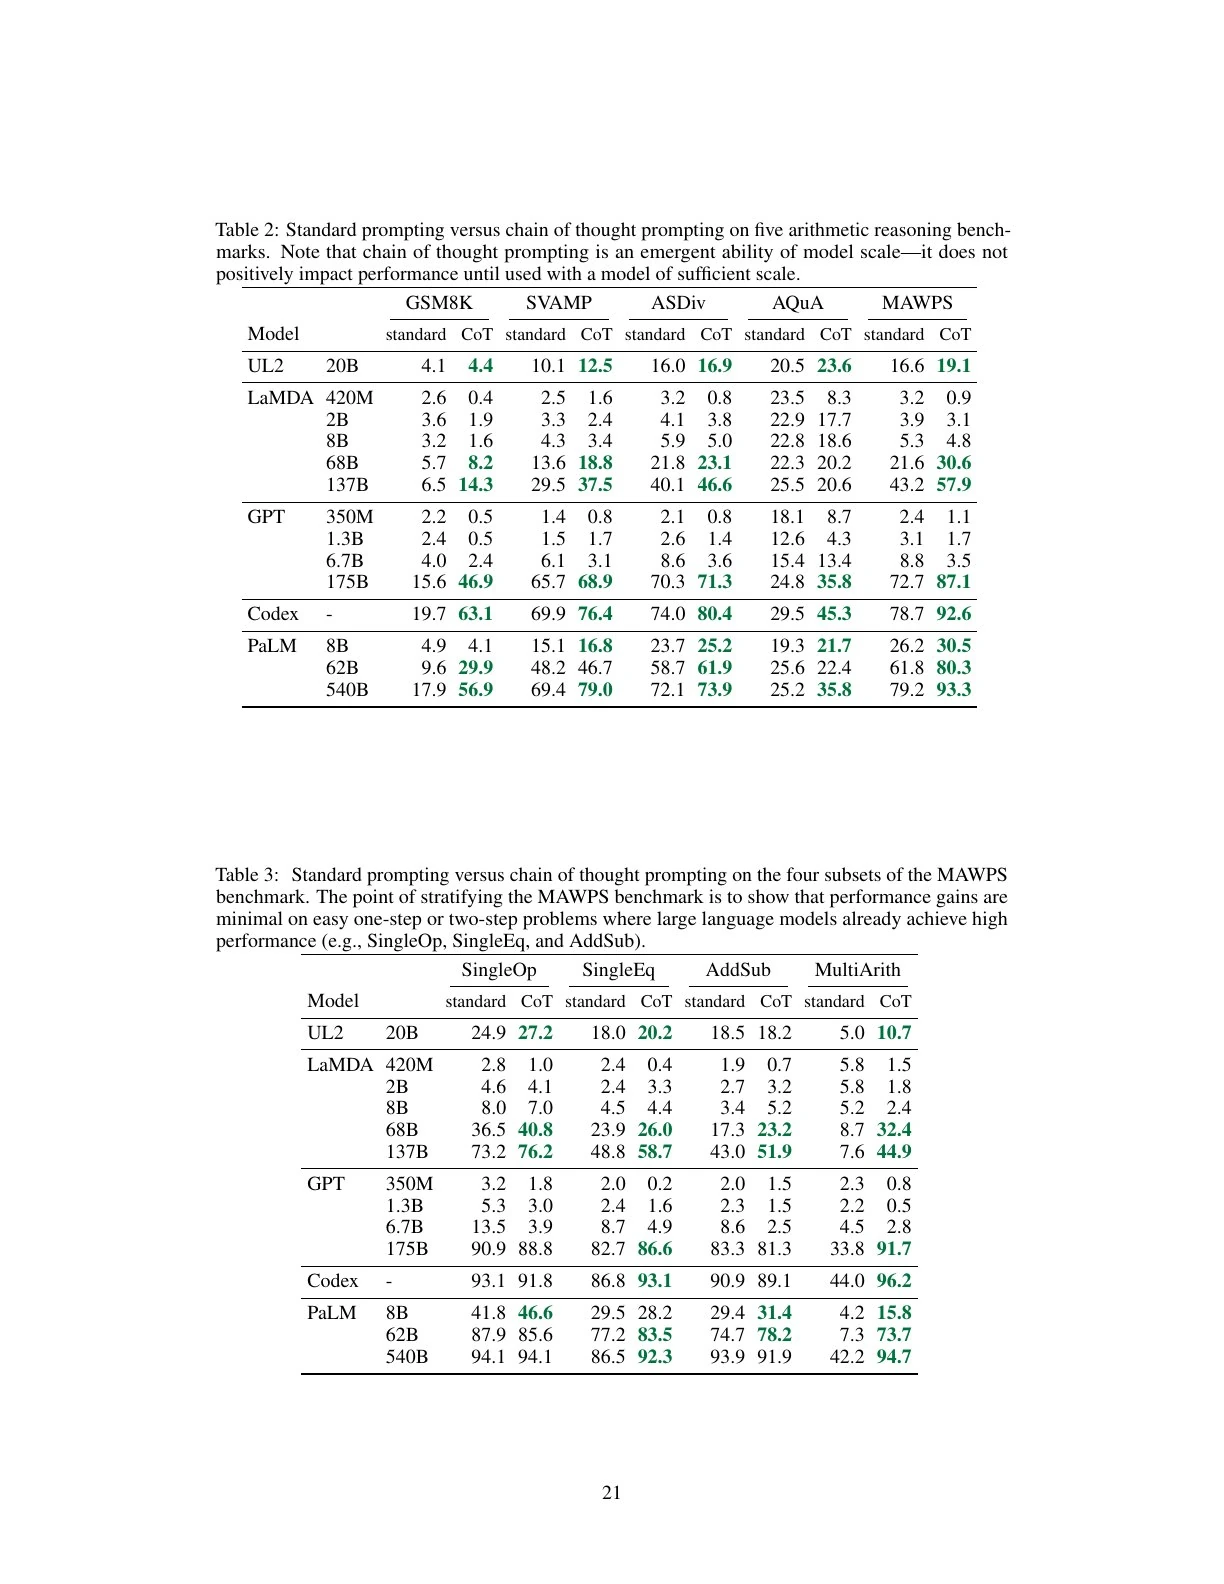
- 算术推理:GSM8K, SVAMP, AQuA, ASDiv, MAWPS(含 SingleOp, SingleEq, AddSub, MultiArith)
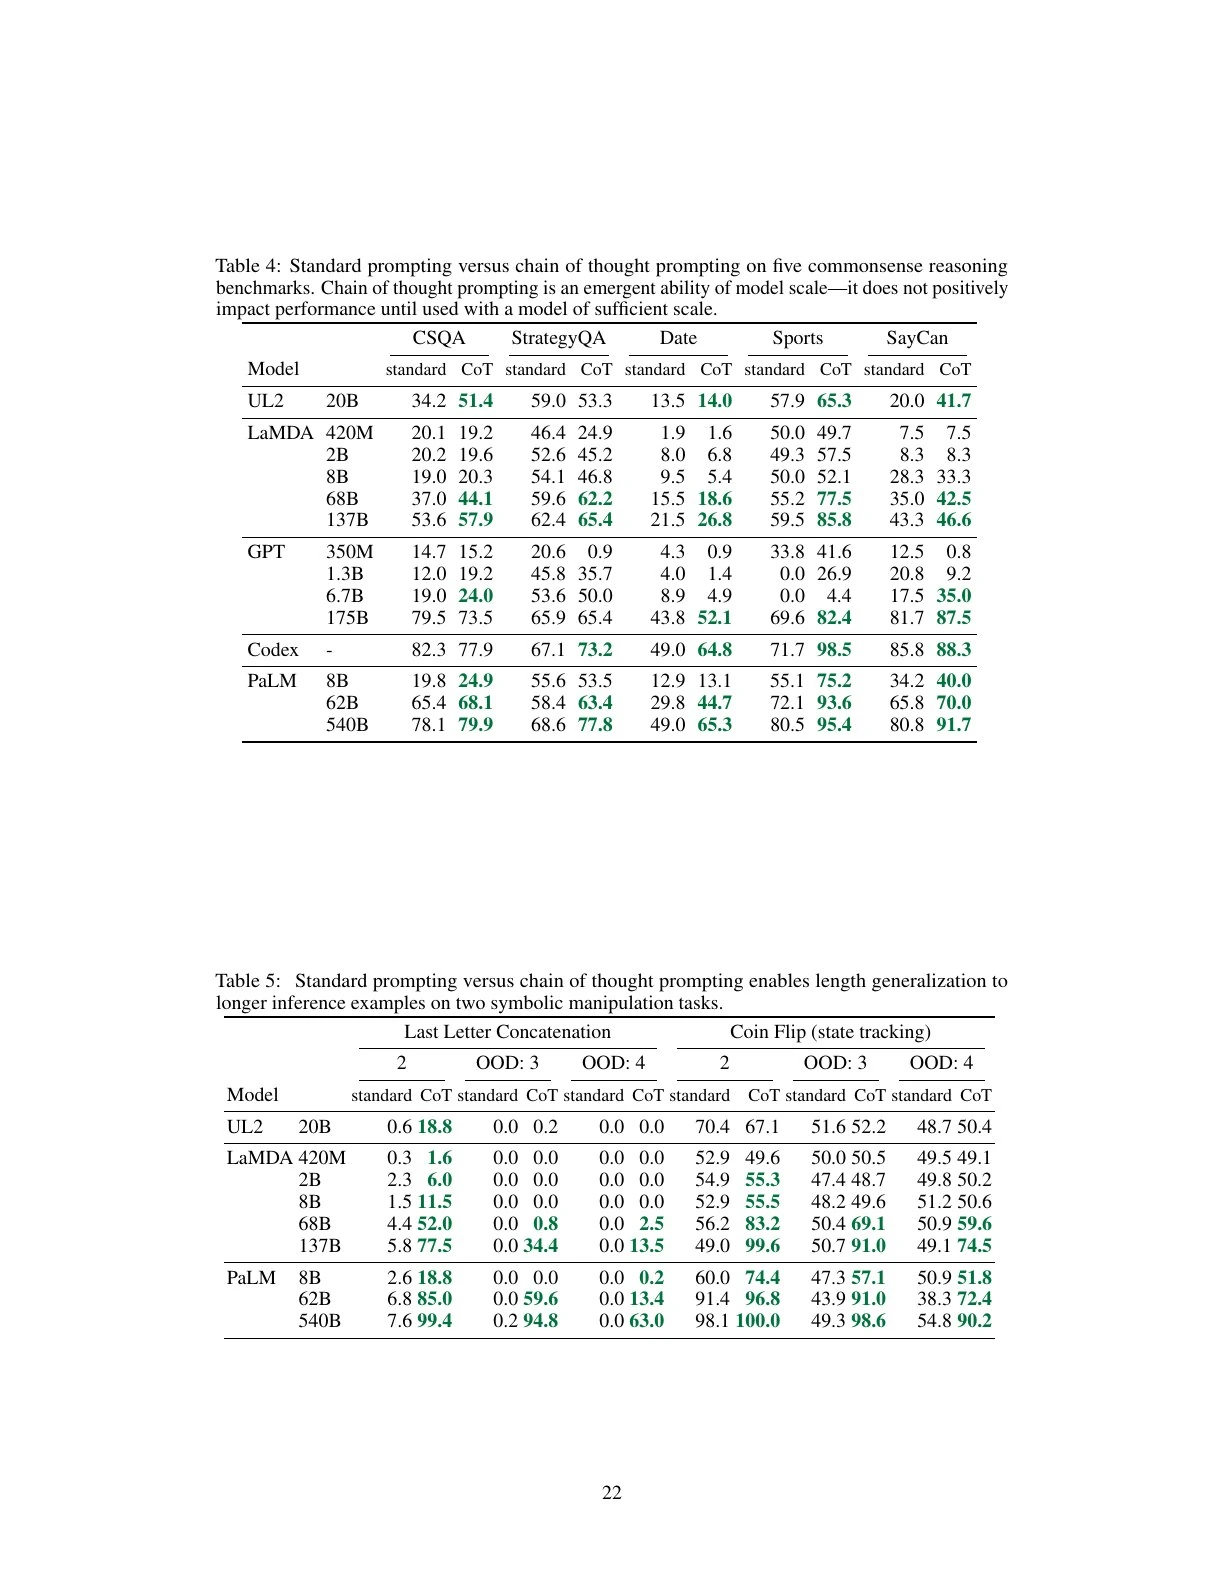
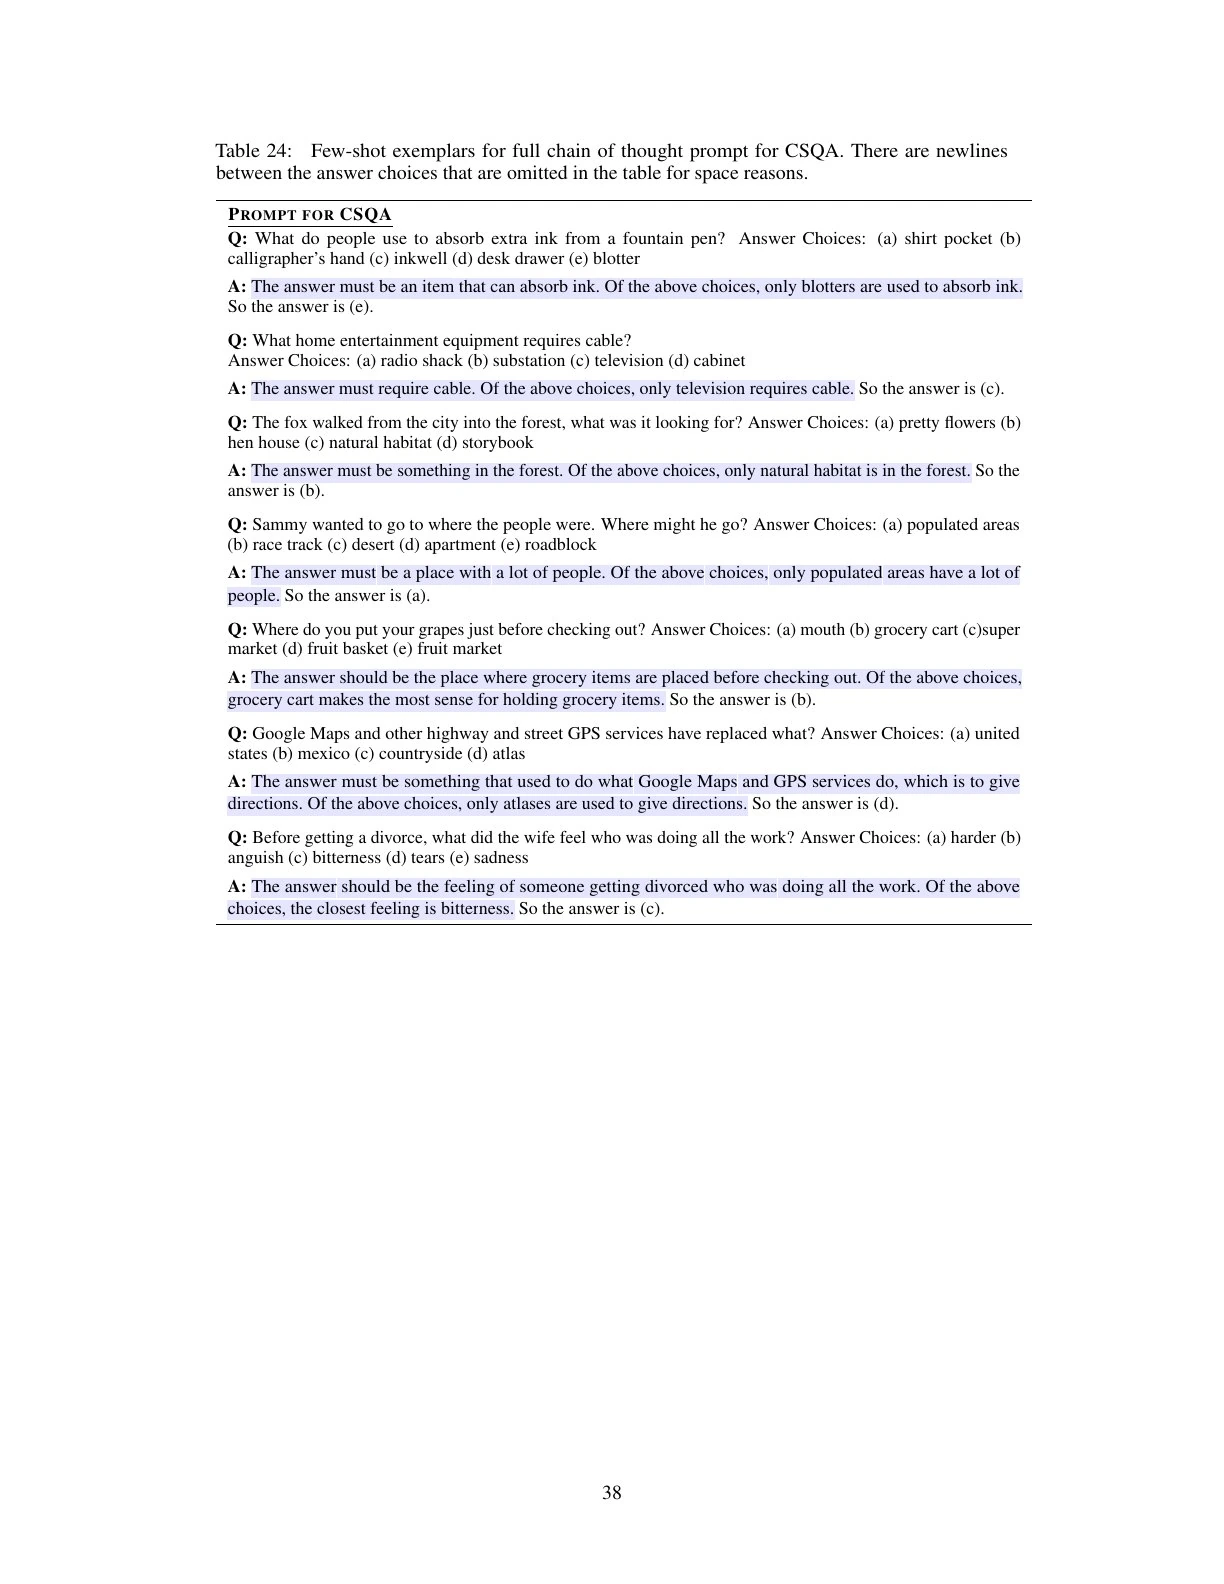
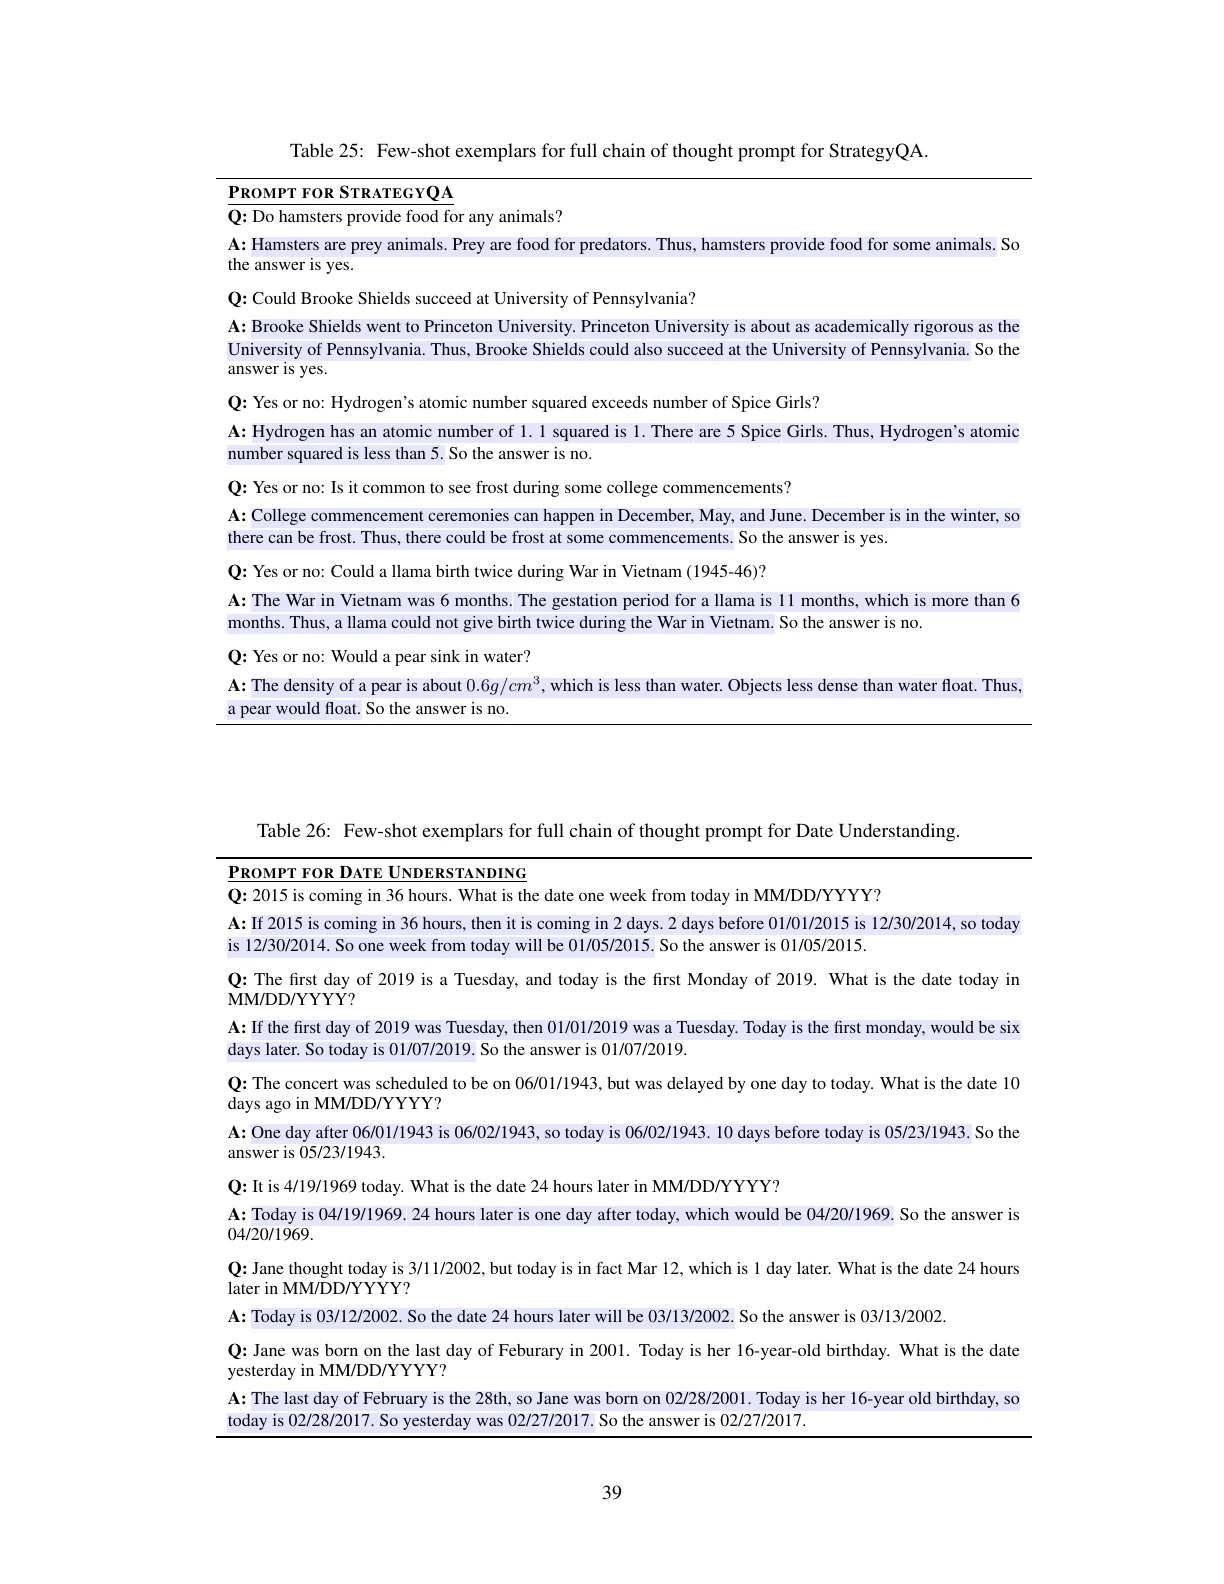
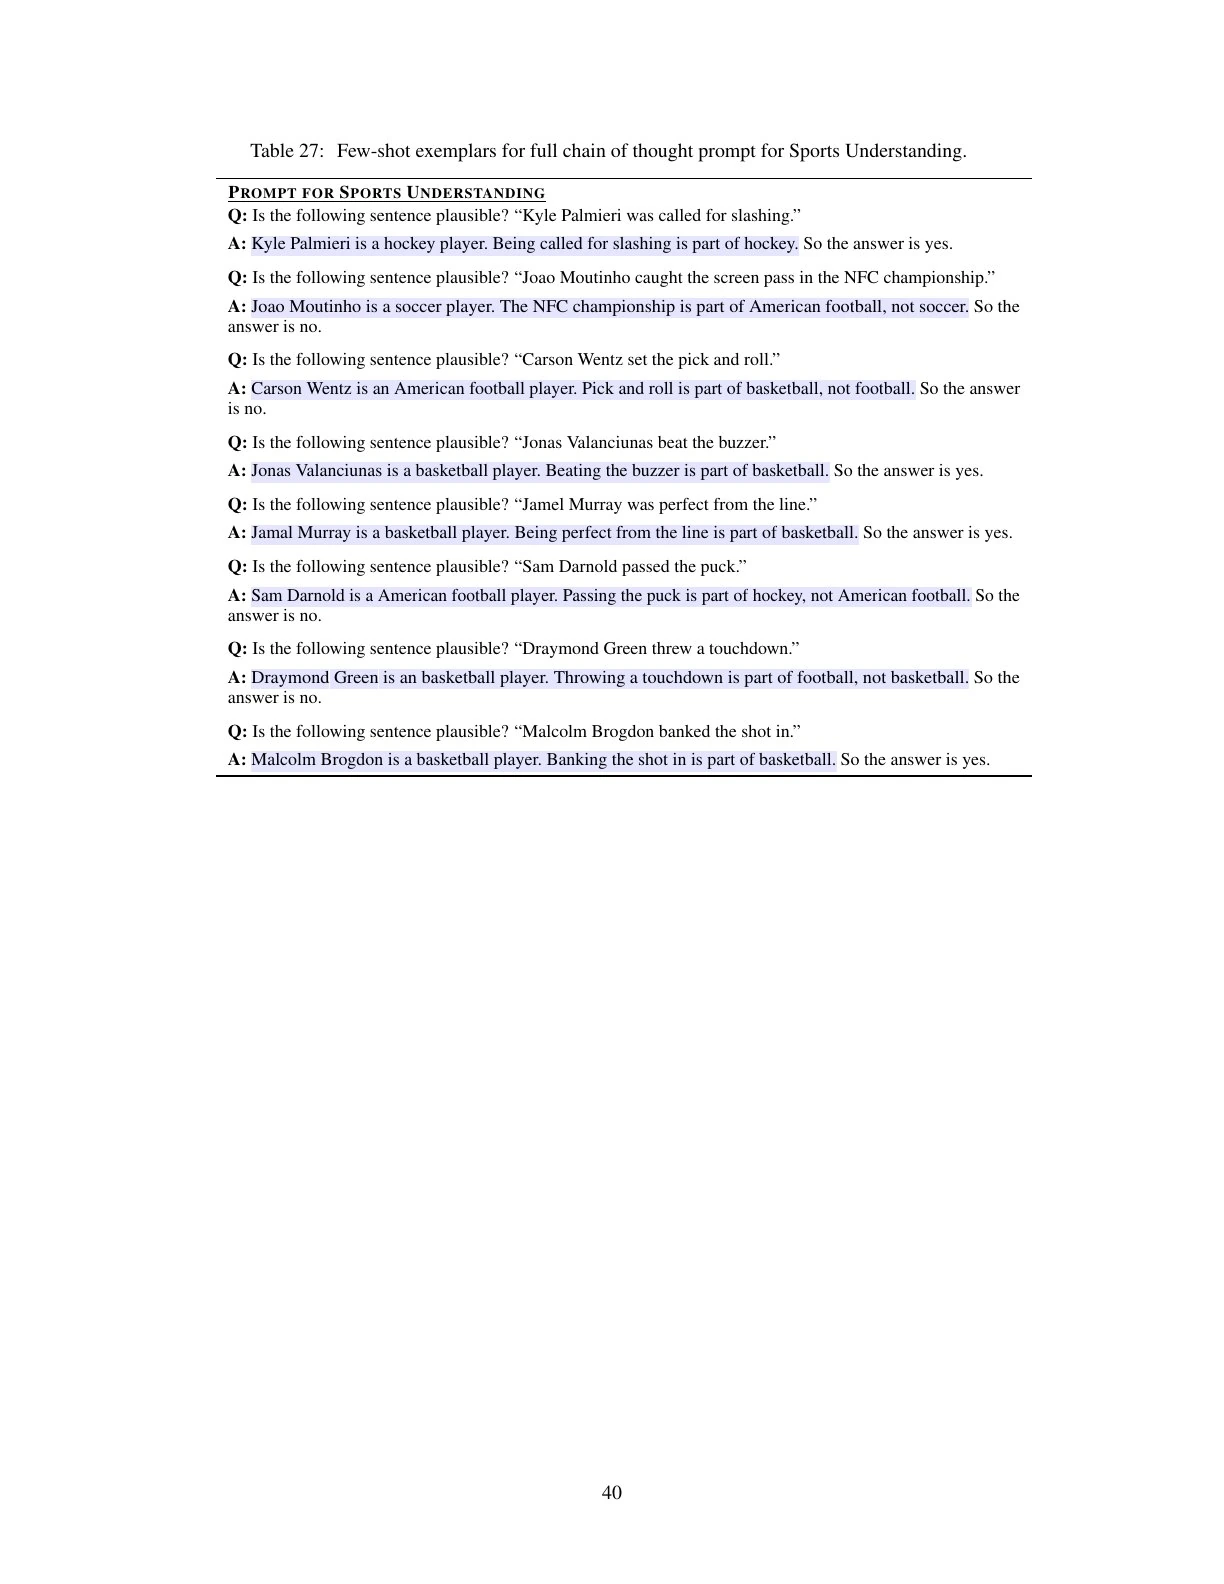
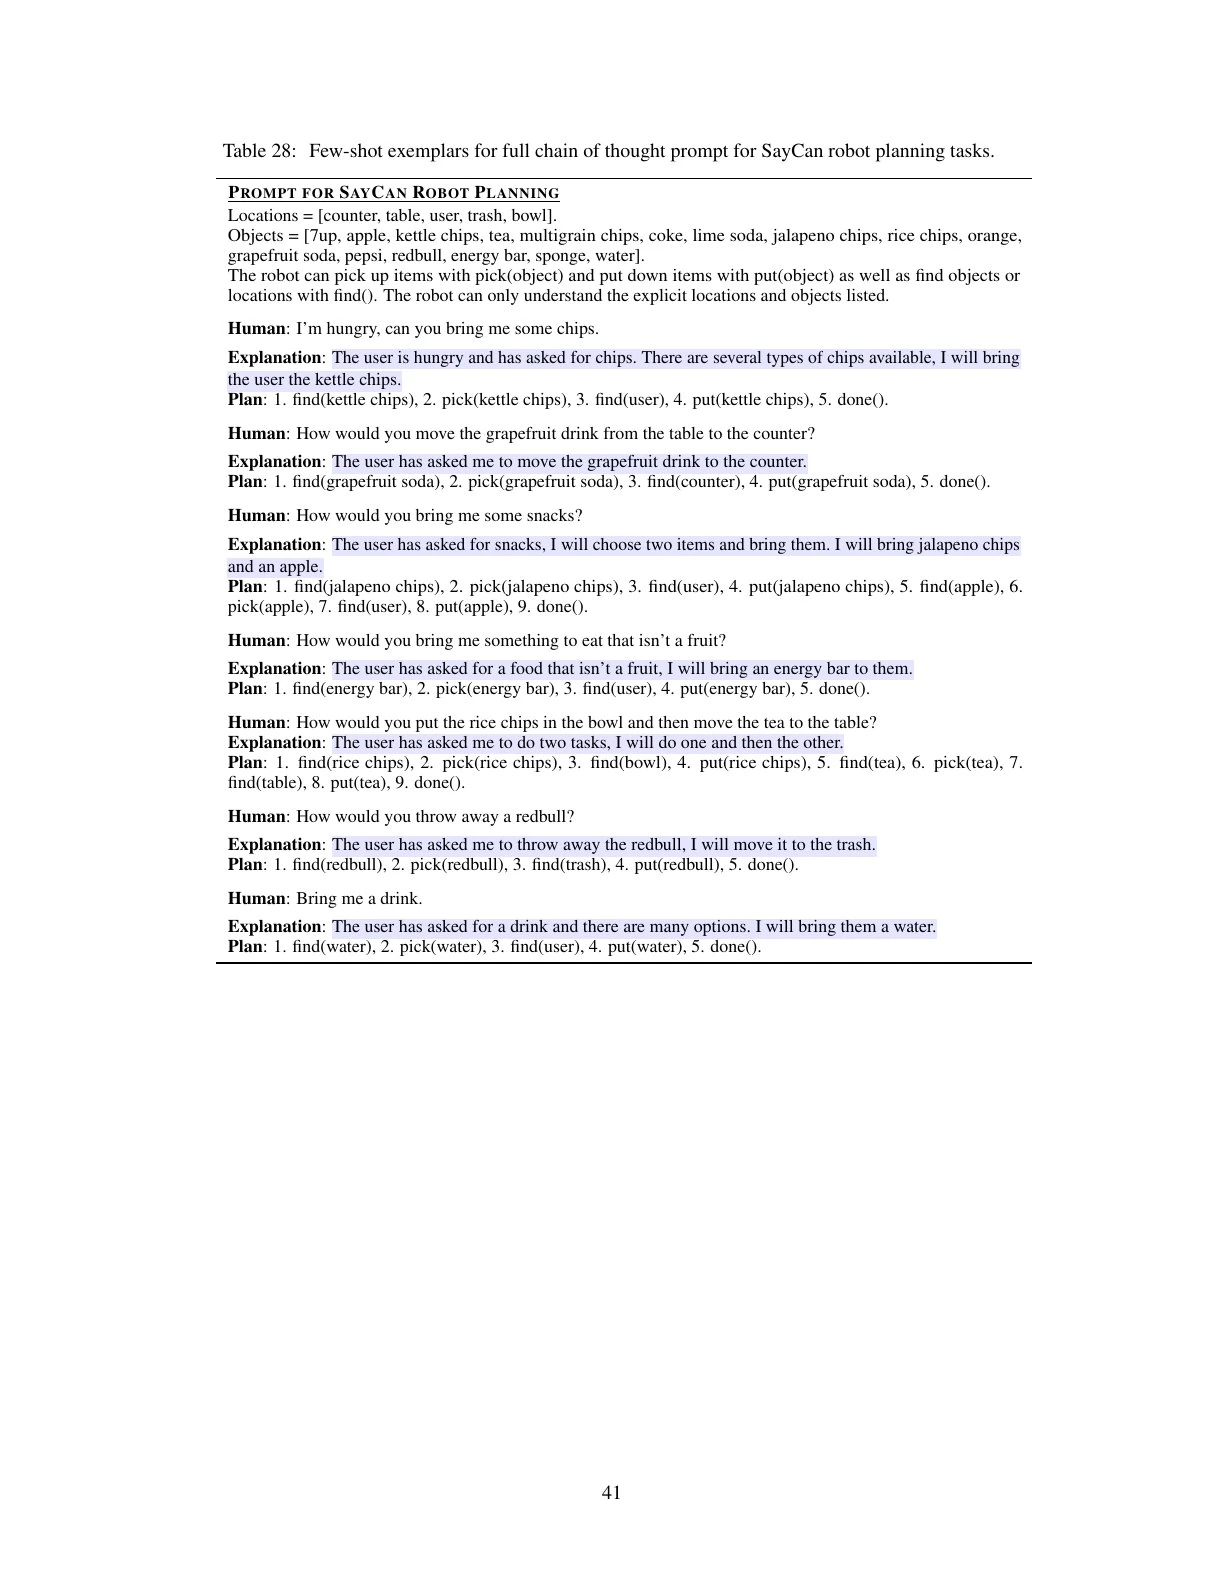
- 常识推理:CSQA, StrategyQA, Date Understanding, Sports Understanding, SayCan
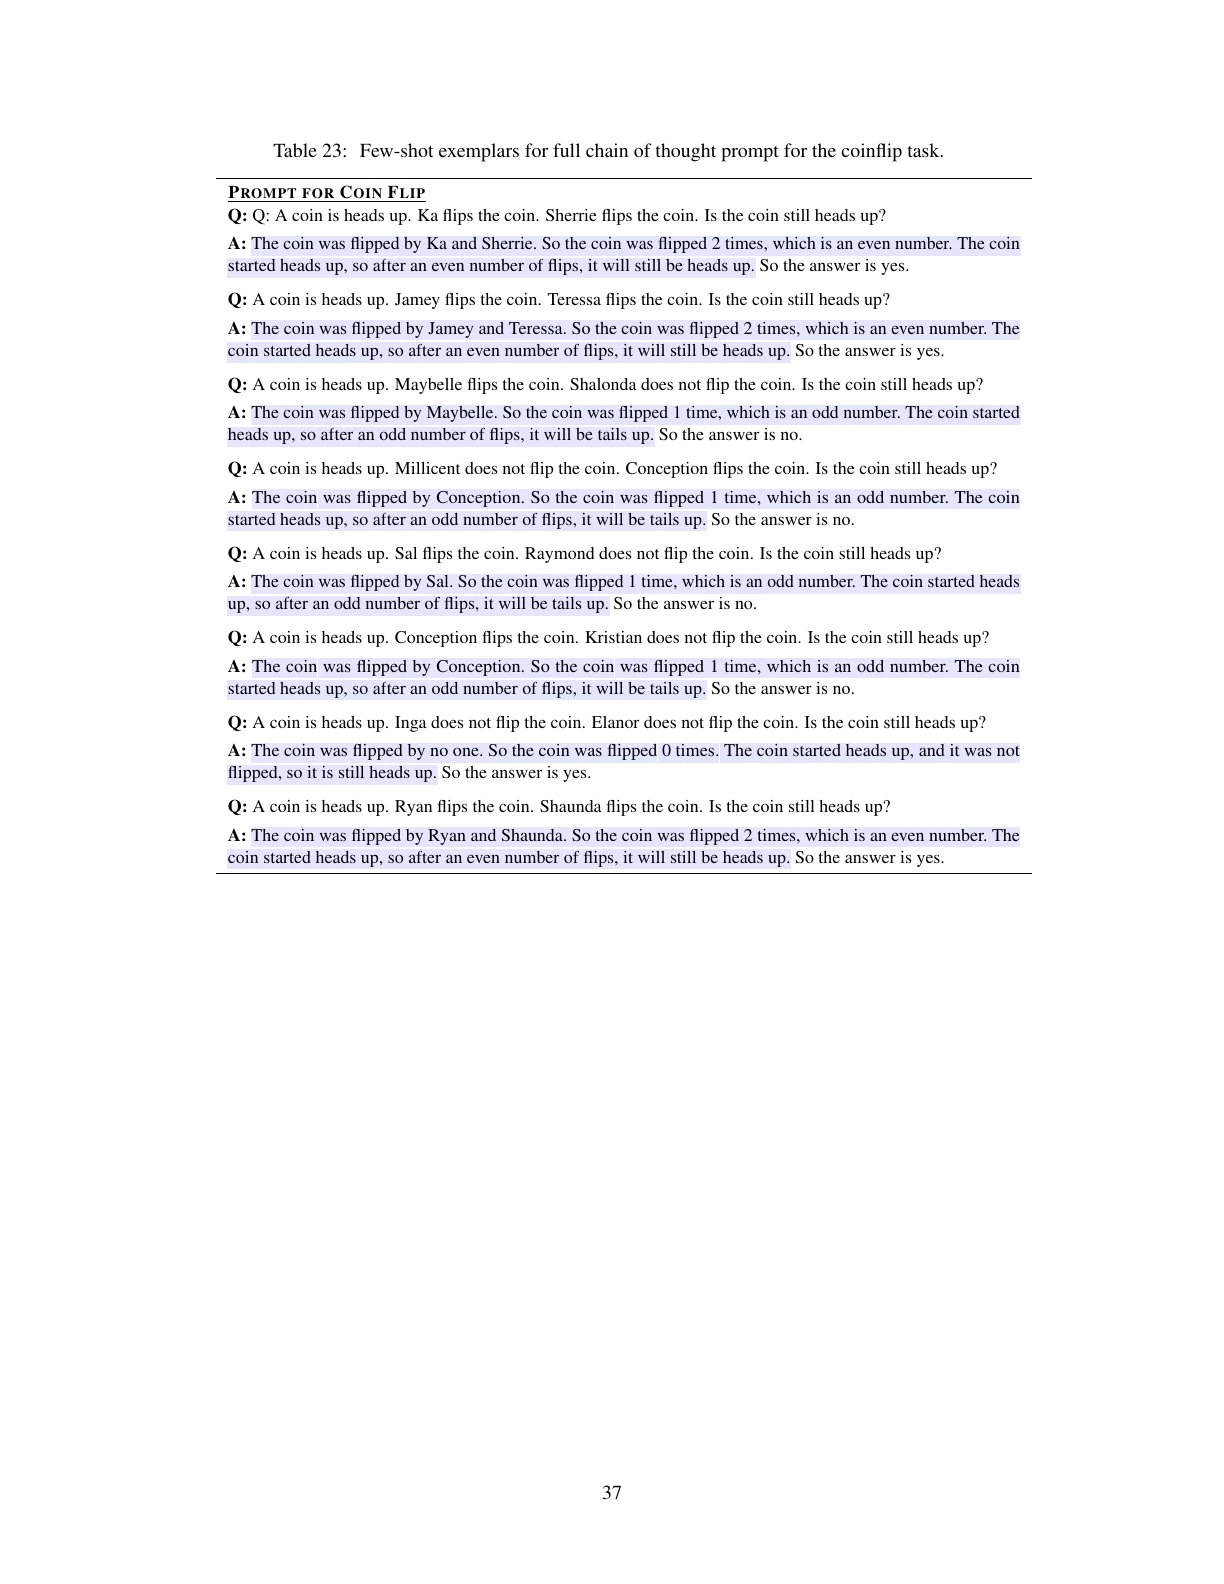
- 符号推理:Last letter concatenation, Coin flip
使用的模型
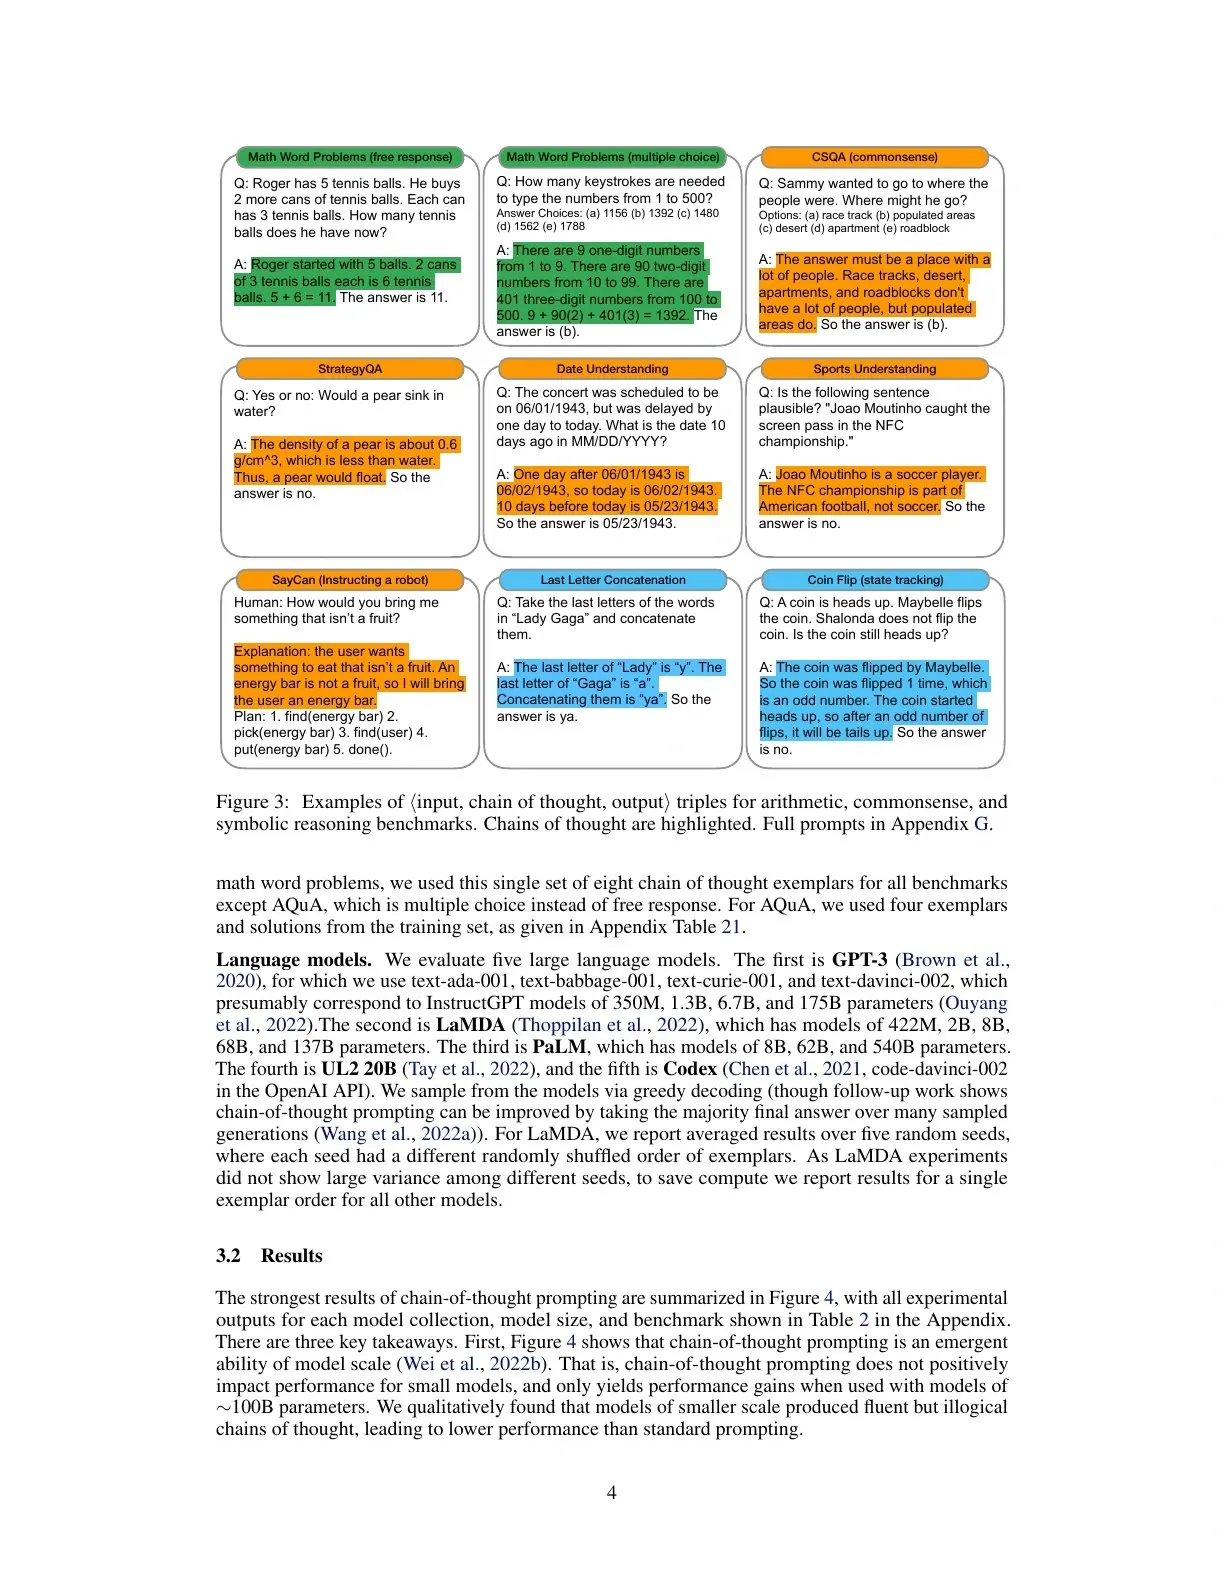
- GPT-3(350M ~ 175B)
- LaMDA(422M ~ 137B)
- PaLM(8B ~ 540B)
- UL2-20B
- Codex(code-davinci-002)
关键结果
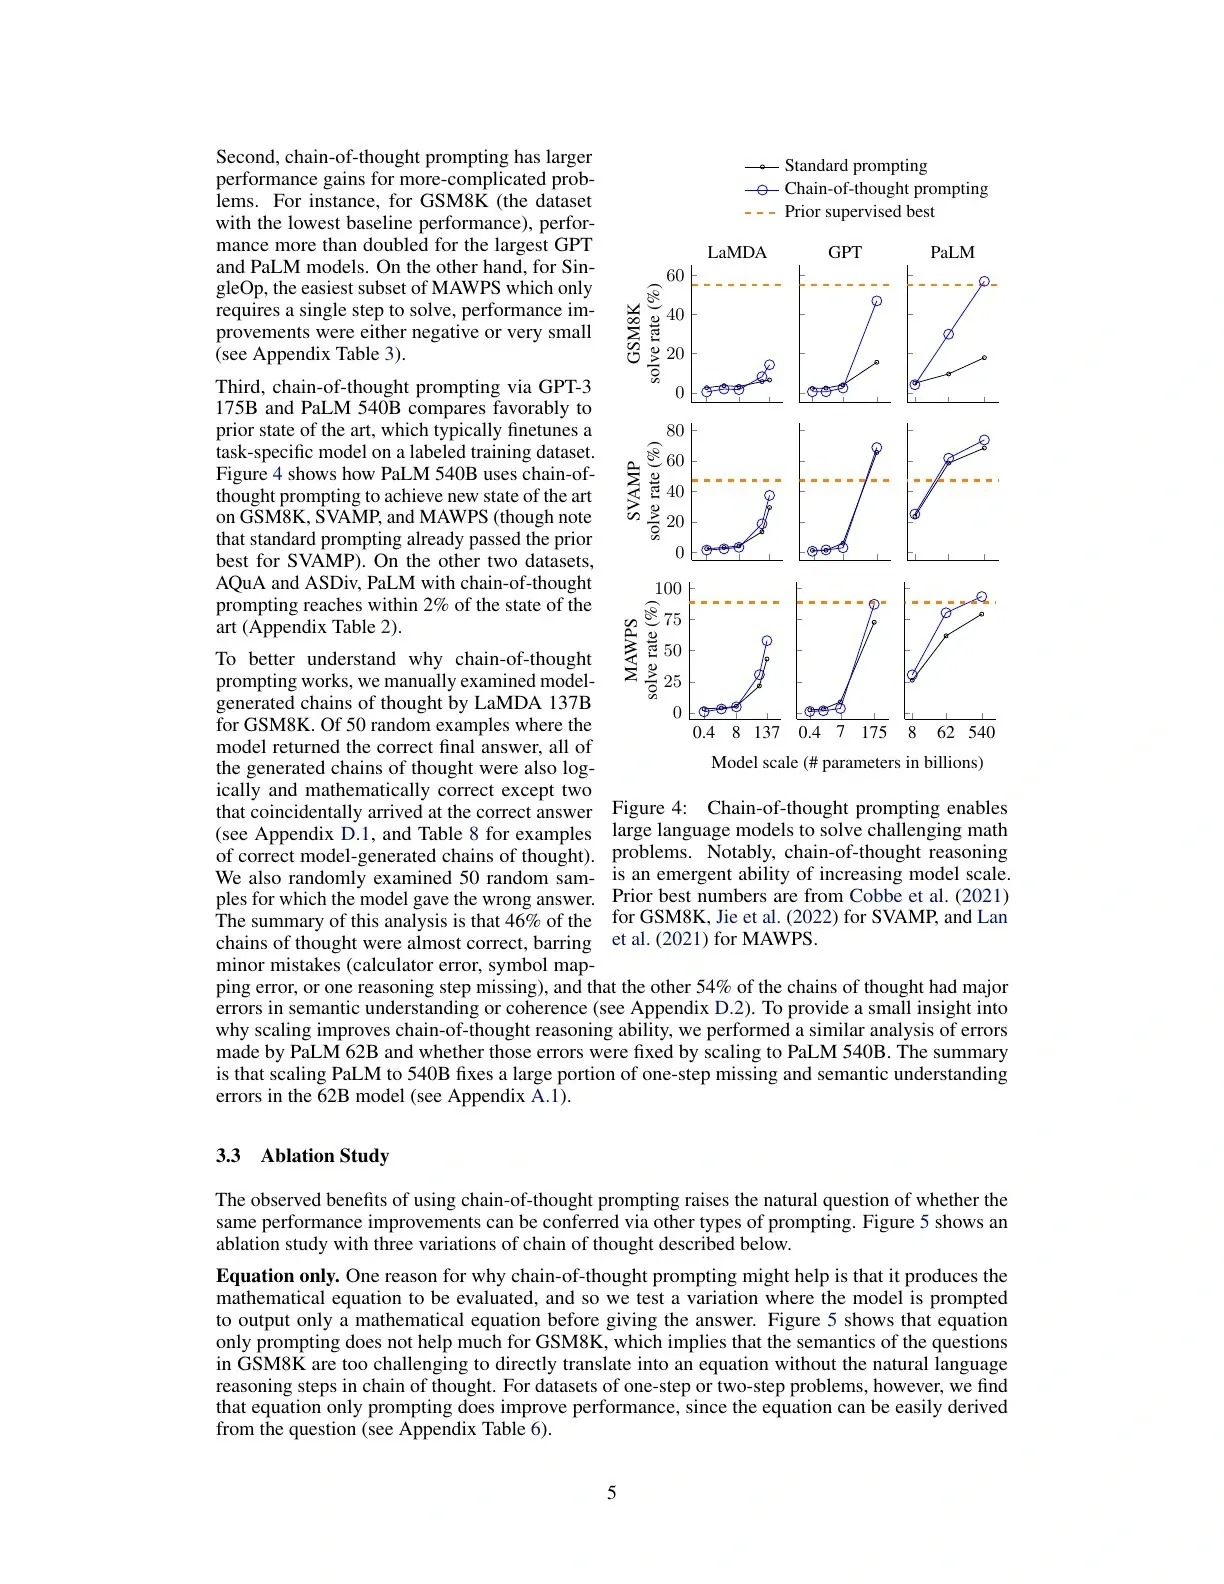
1. 算术推理(GSM8K 重点)
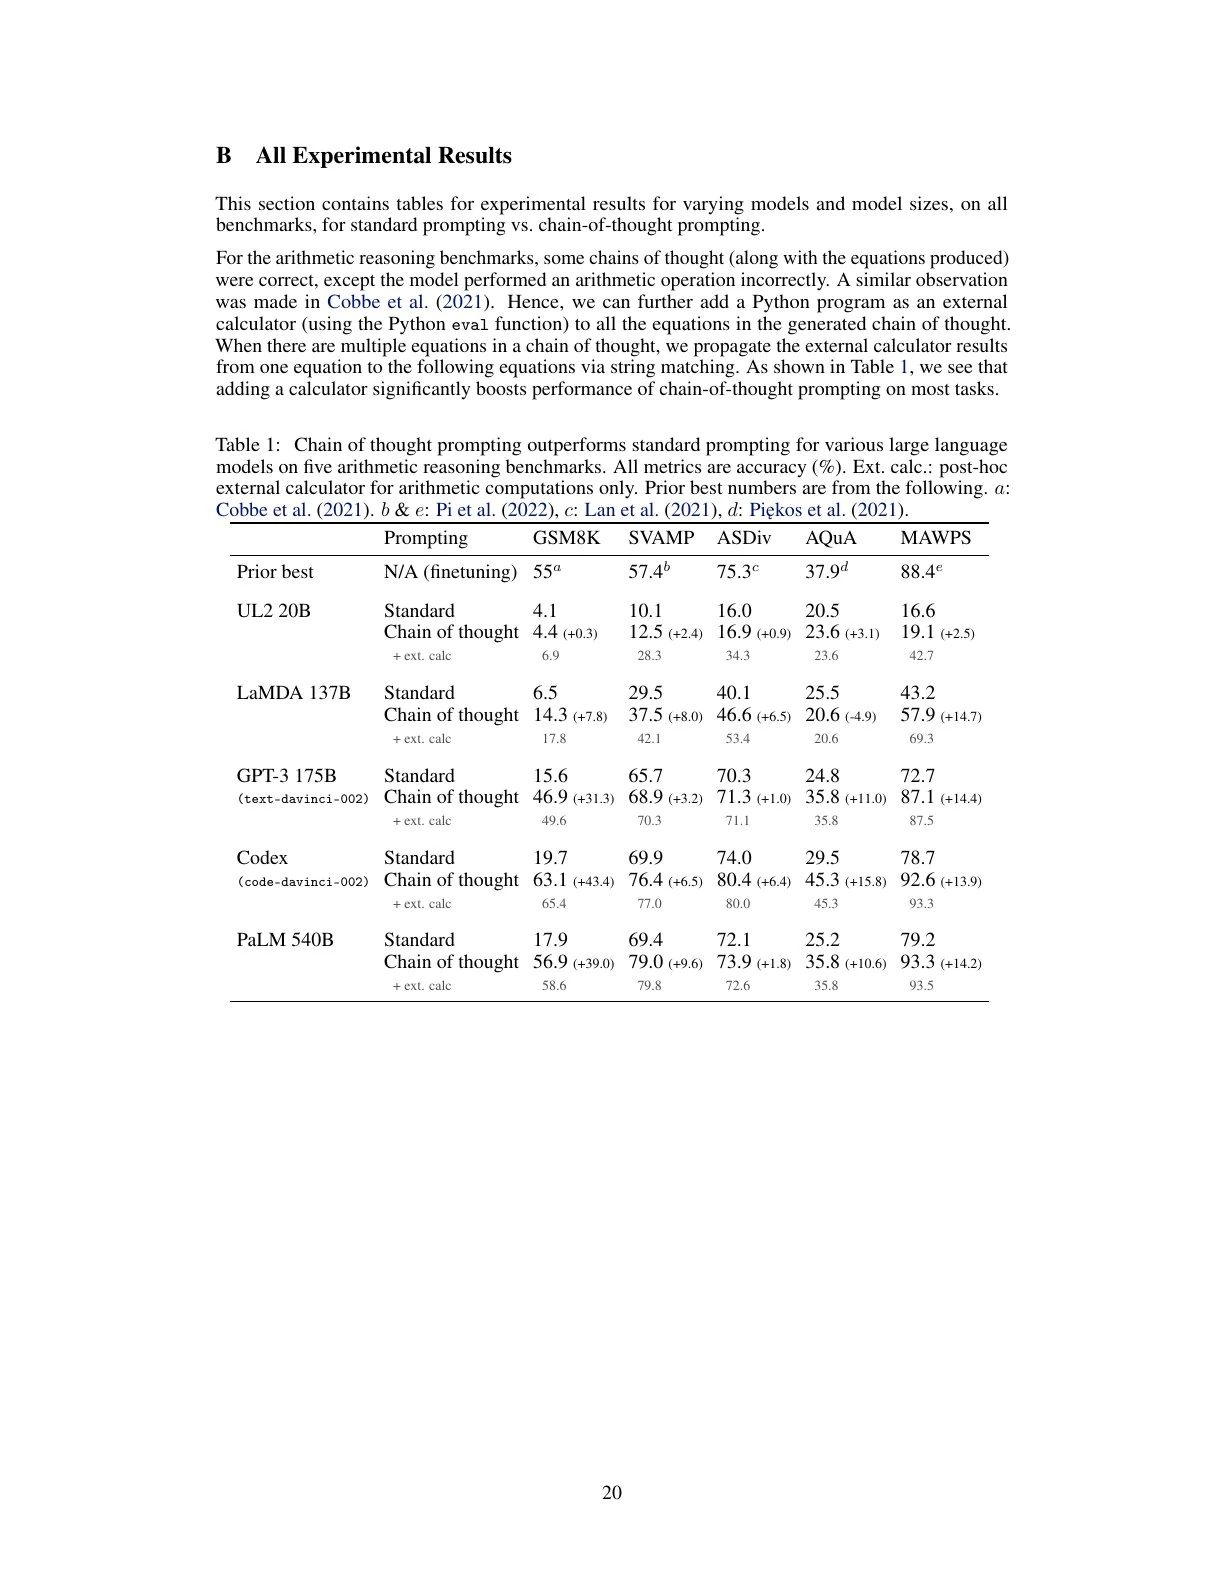
| 模型 | 标准提示 | CoT 提示 | 提升 |
|---|---|---|---|
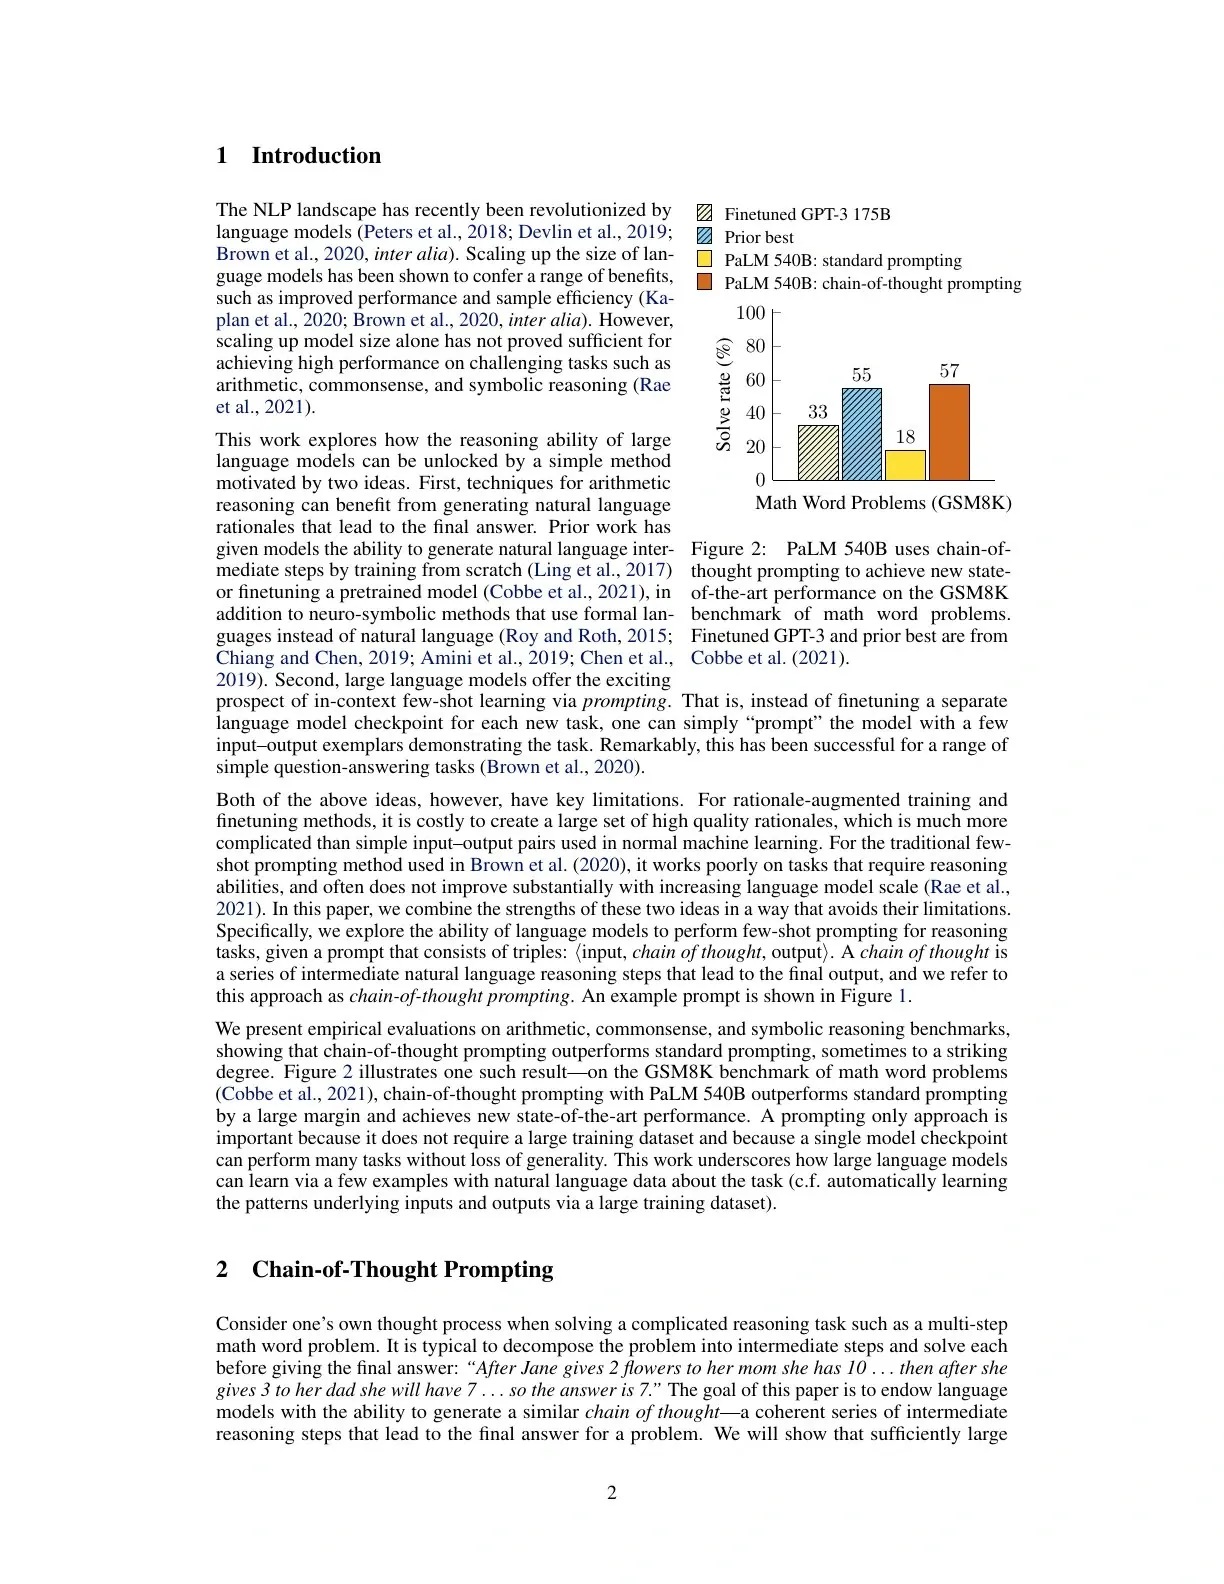
| PaLM 540B | 17.9% | 56.9% | +39% |
| GPT-3 175B | 15.6% | 46.9% | +31.3% |
| LaMDA 137B | 6.5% | 14.3% | +7.8% |
- CoT + PaLM 540B 达到当时 SOTA(56.9%),超过微调的 GPT-3(55%)。
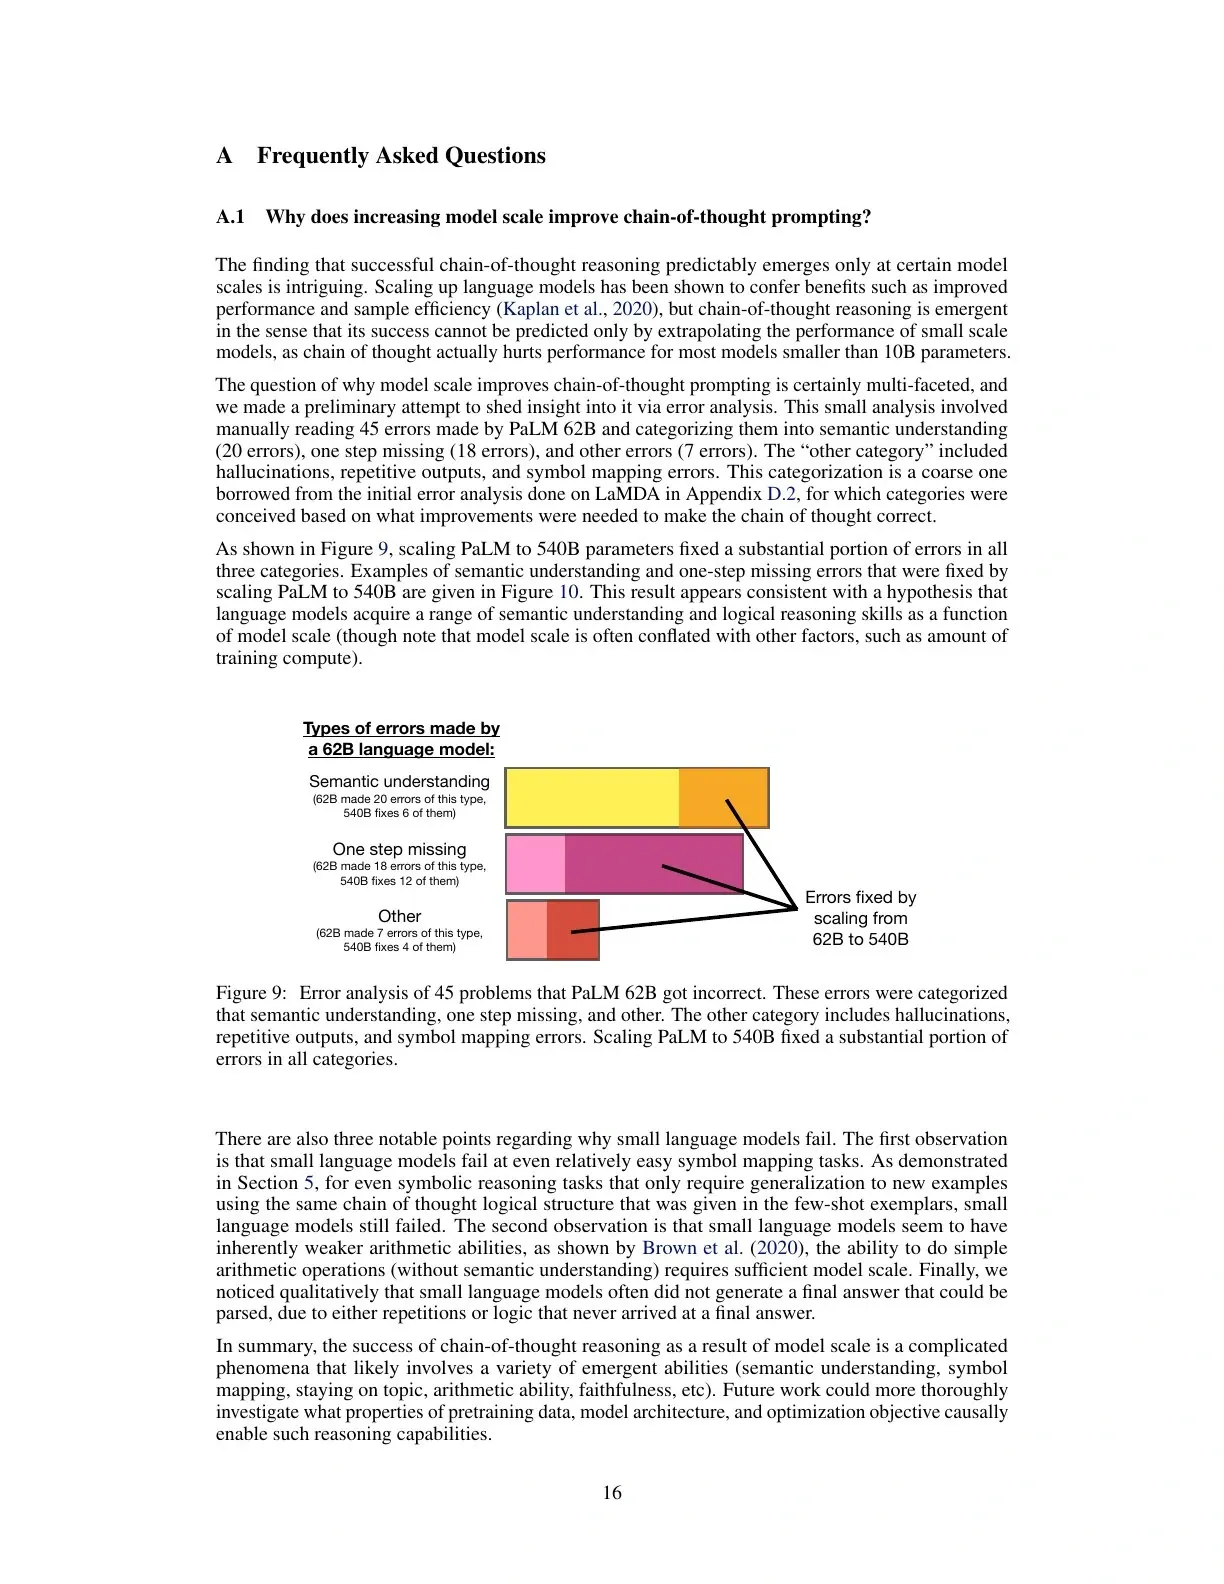
2. 模型规模是门槛(“涌现能力”)
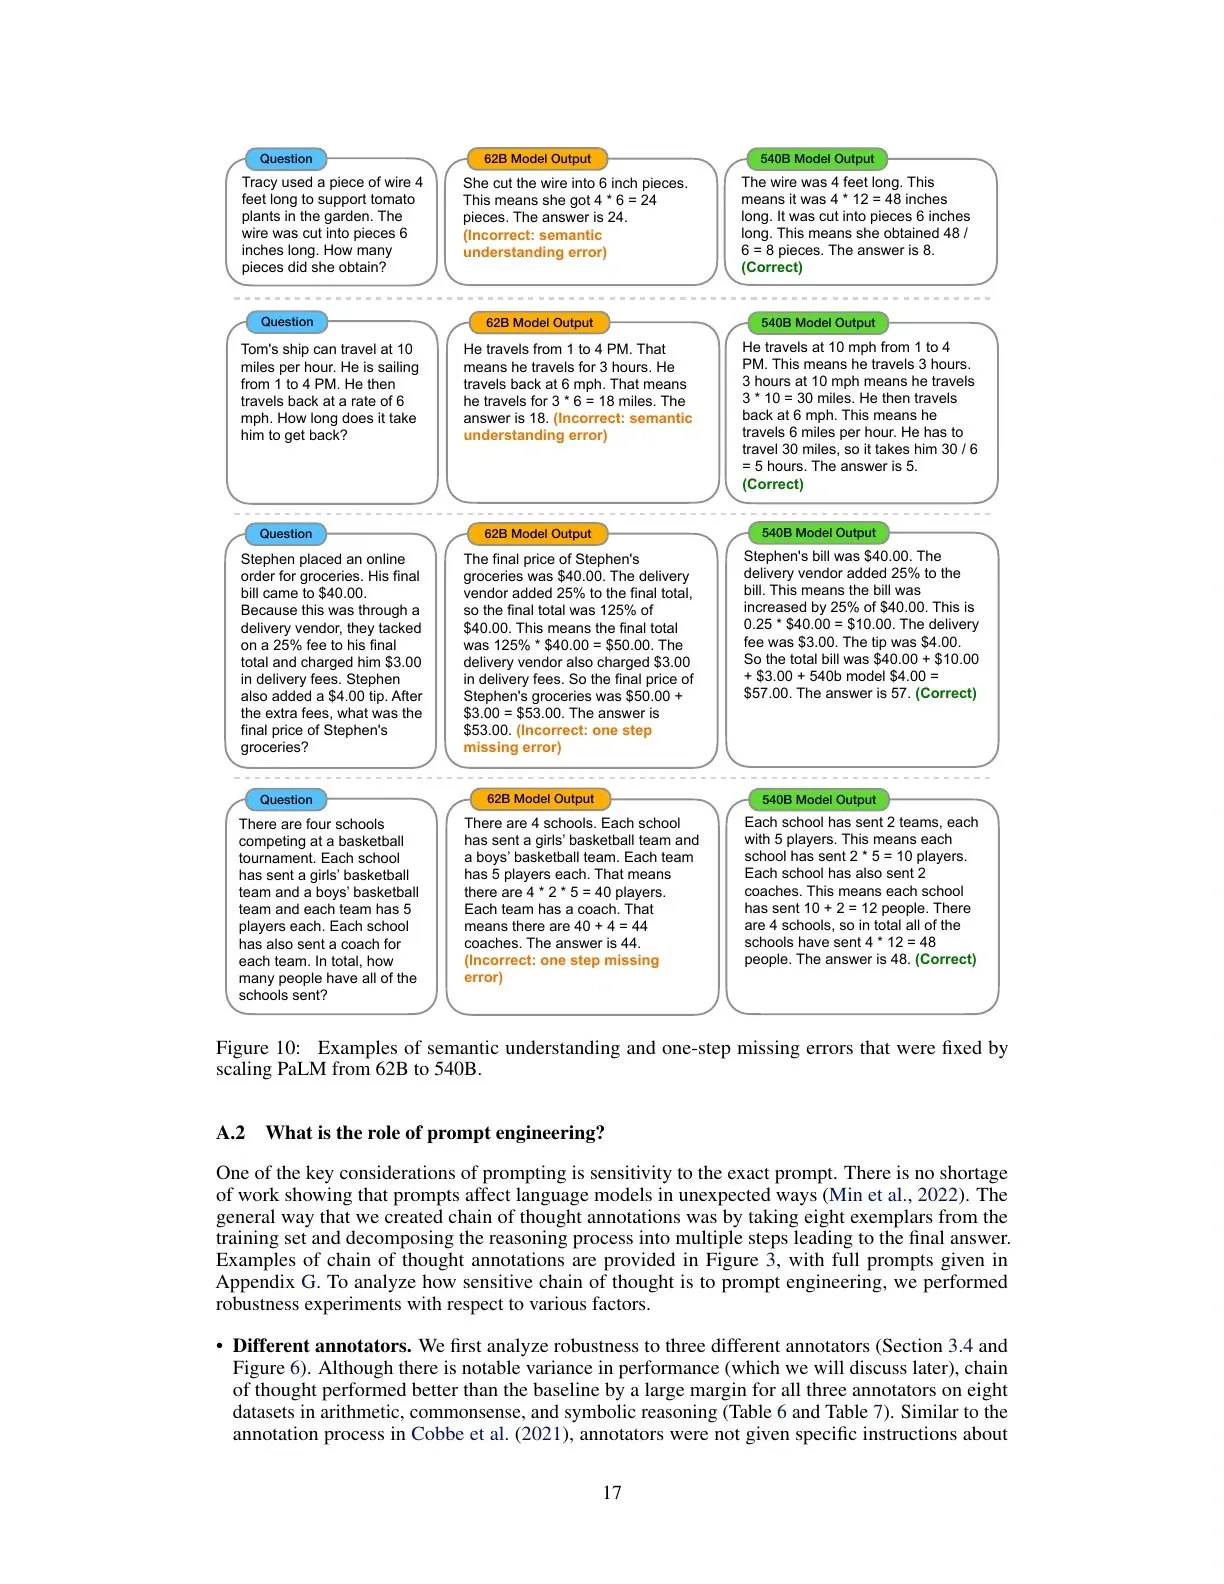
- 模型 < 100B 参数时,CoT 可能 损害 性能(生成流畅但错误的推理)。
- 模型 ≥ 100B 时,CoT 显著提升性能。 这是“涌现能力”的典型案例。
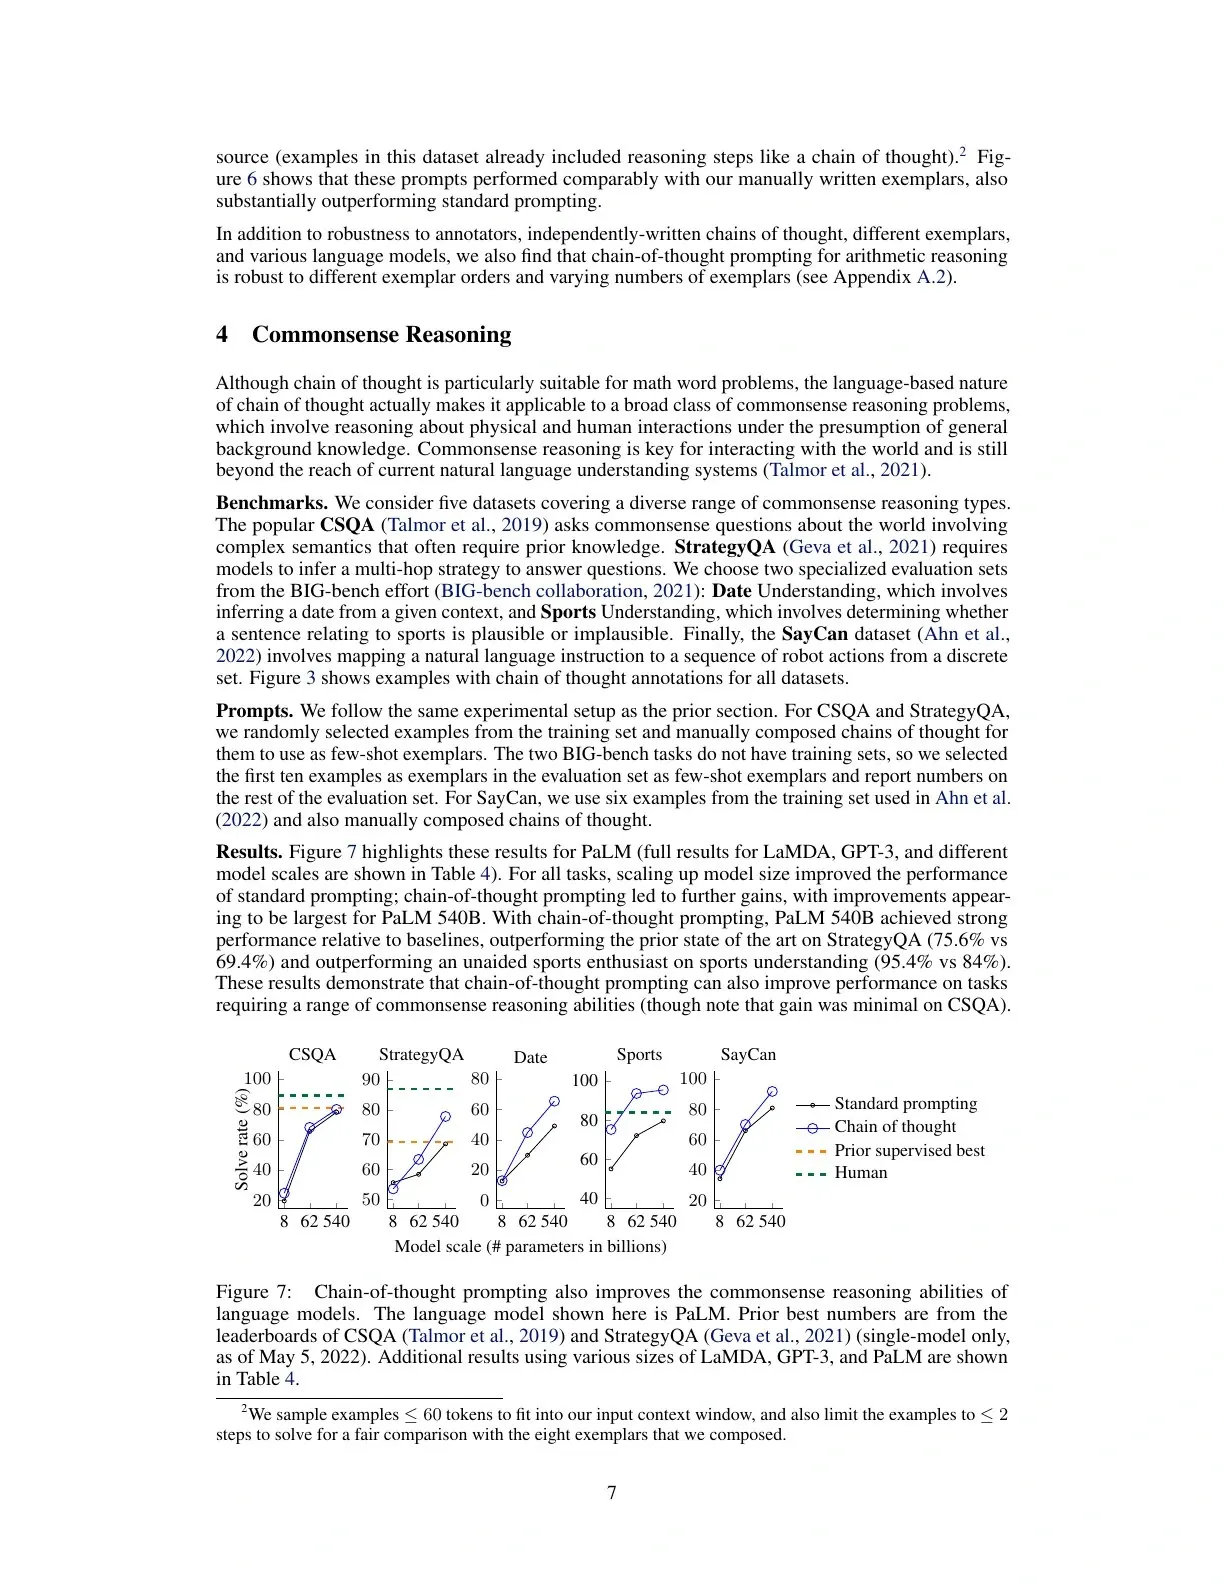
3. 常识推理
| 任务 | 标准提示 (PaLM 540B) | CoT 提示 | 提升 |
|---|---|---|---|
| StrategyQA | 68.6% | 75.6% | +7% |
| Sports Understanding | 80.5% | 95.4% | +14.9% |
| Date Understanding | 49.0% | 65.3% | +16.3% |
| CSQA | 78.1% | 79.9% | +1.8% |
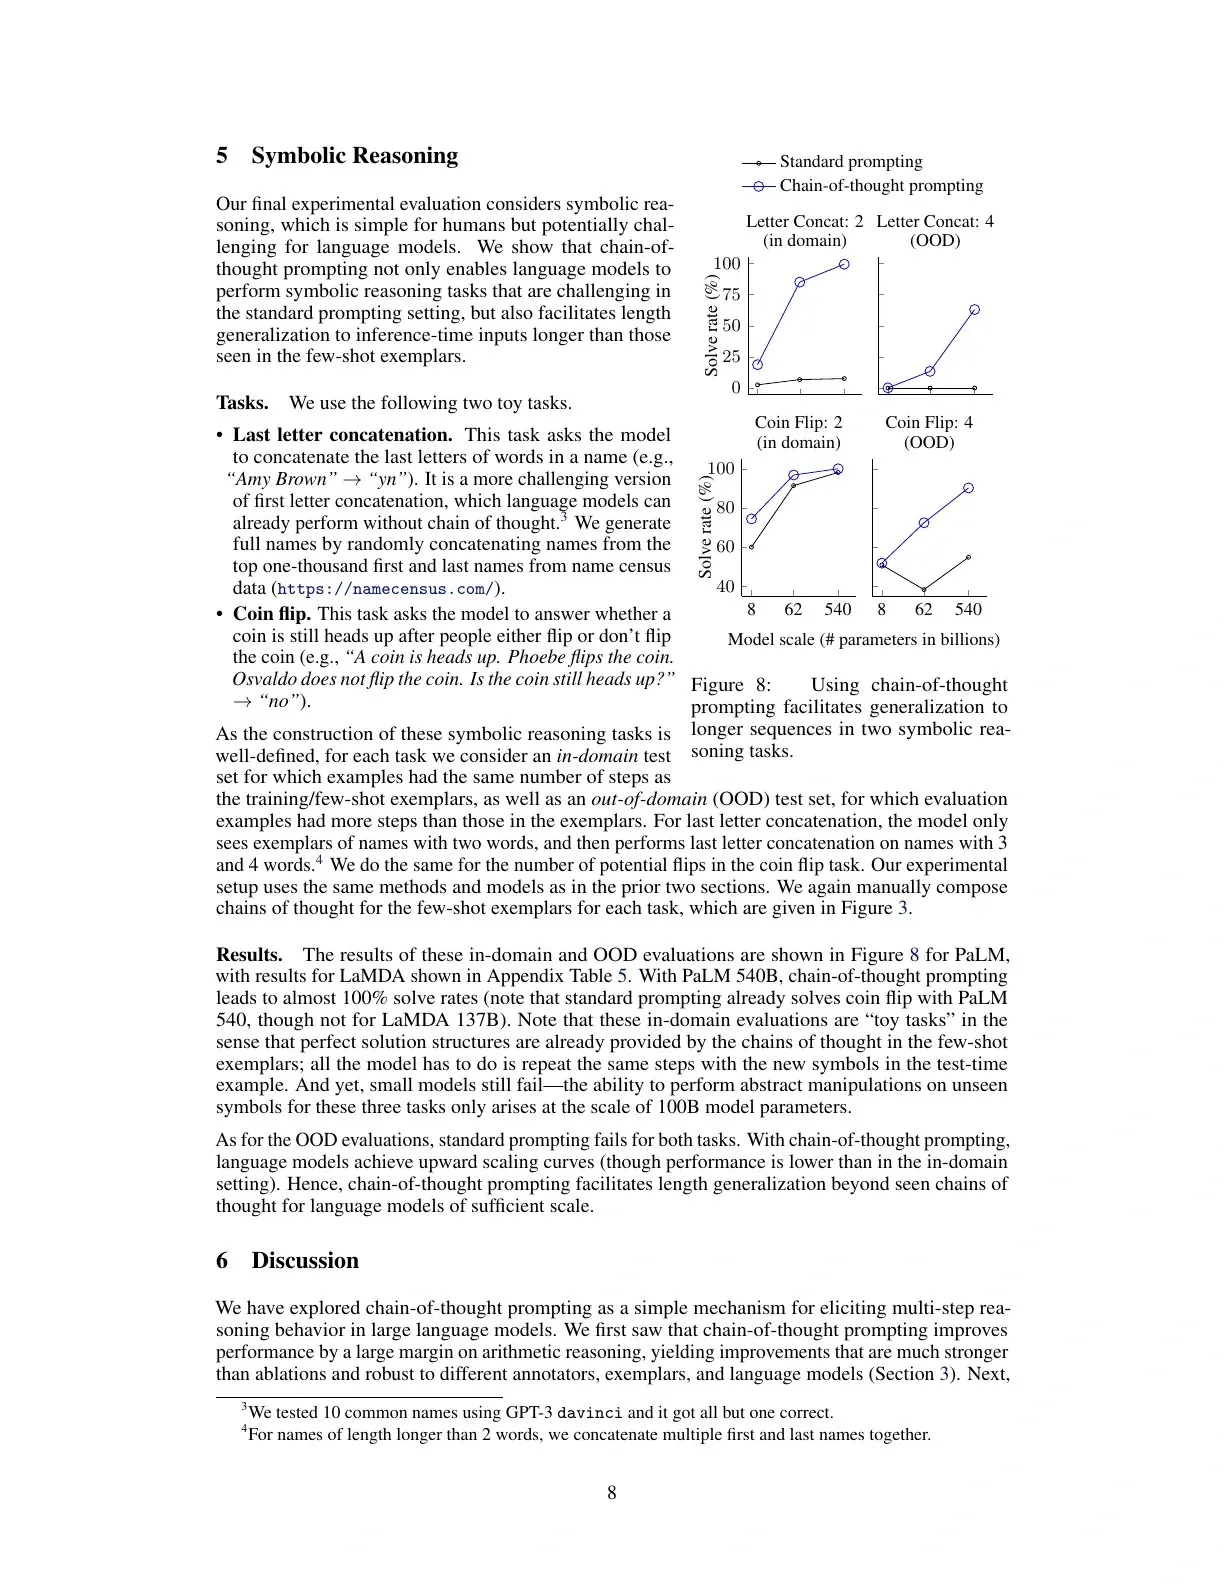
4. 符号推理(长度泛化)
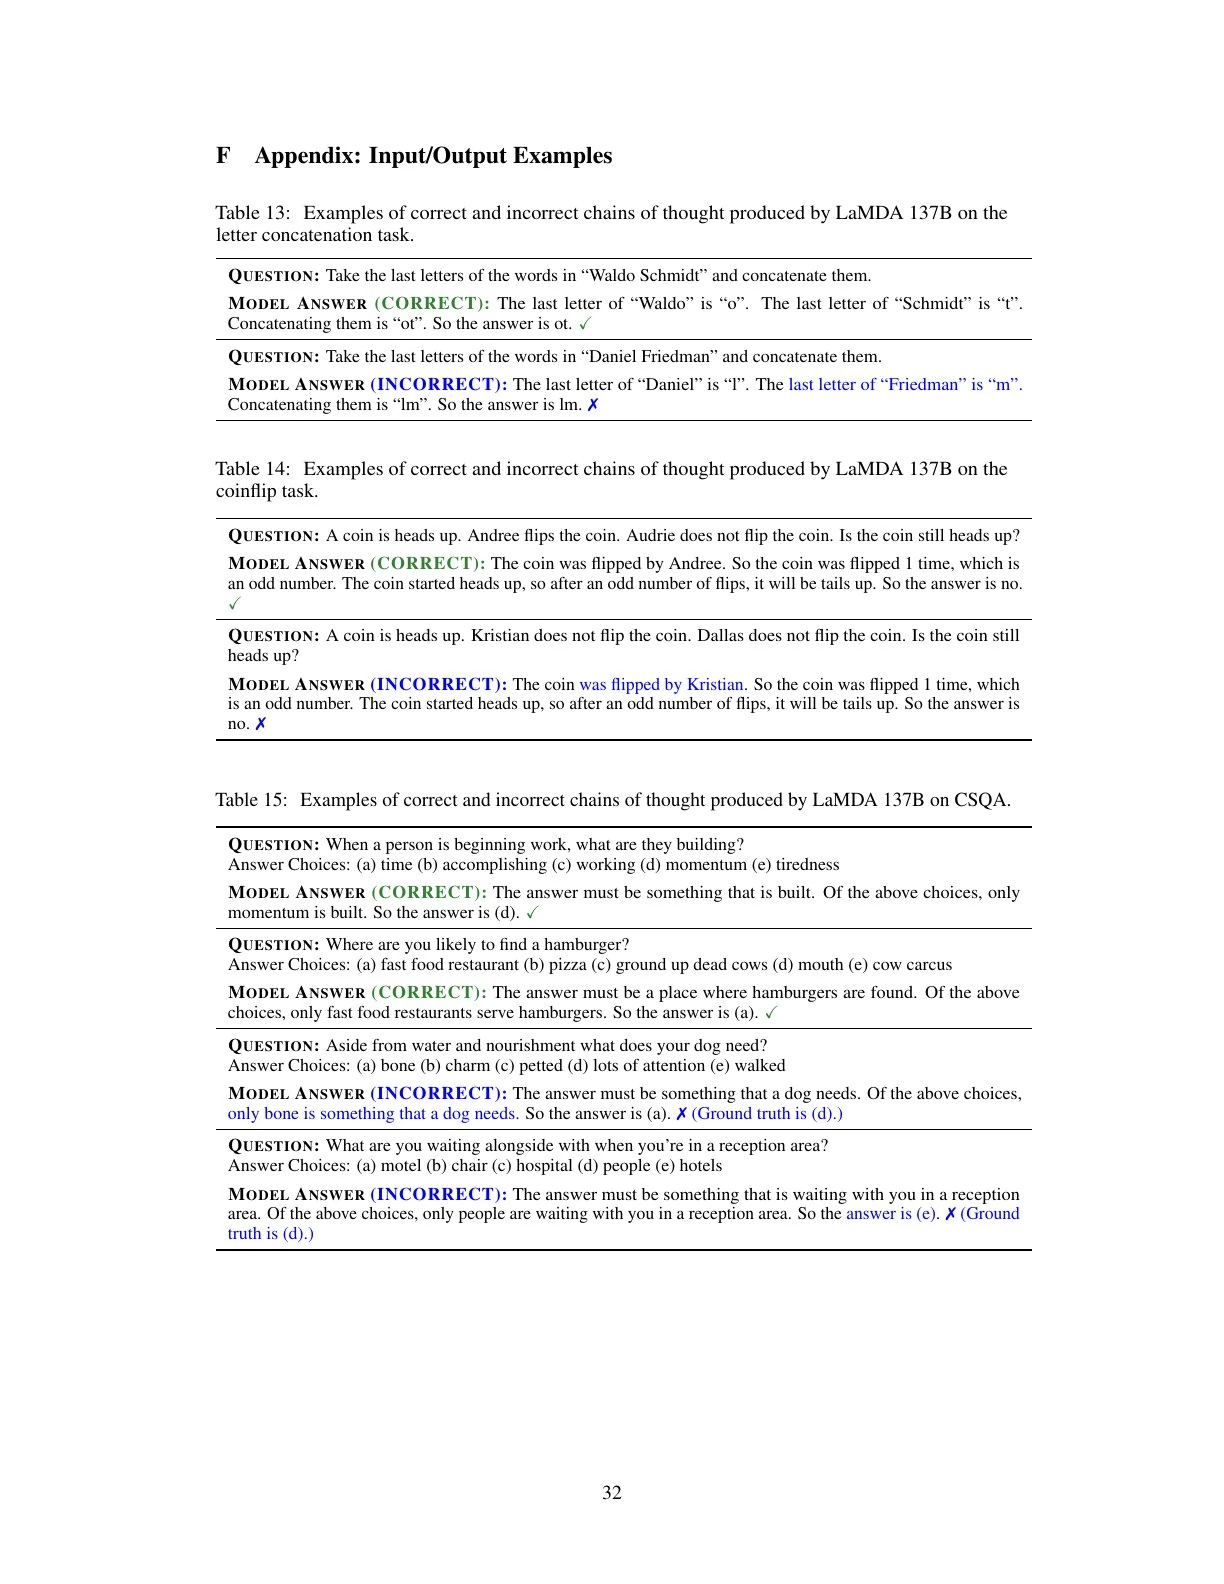
- Last letter concatenation(4 词):标准提示 0.2% → CoT 94.8%。
- Coin flip(4 次翻转):标准提示 63.0% → CoT 98.1%。
- CoT 能够 泛化到比示例更长的序列,说明模型学到了重复执行模式的能力。
4. 消融与鲁棒性分析
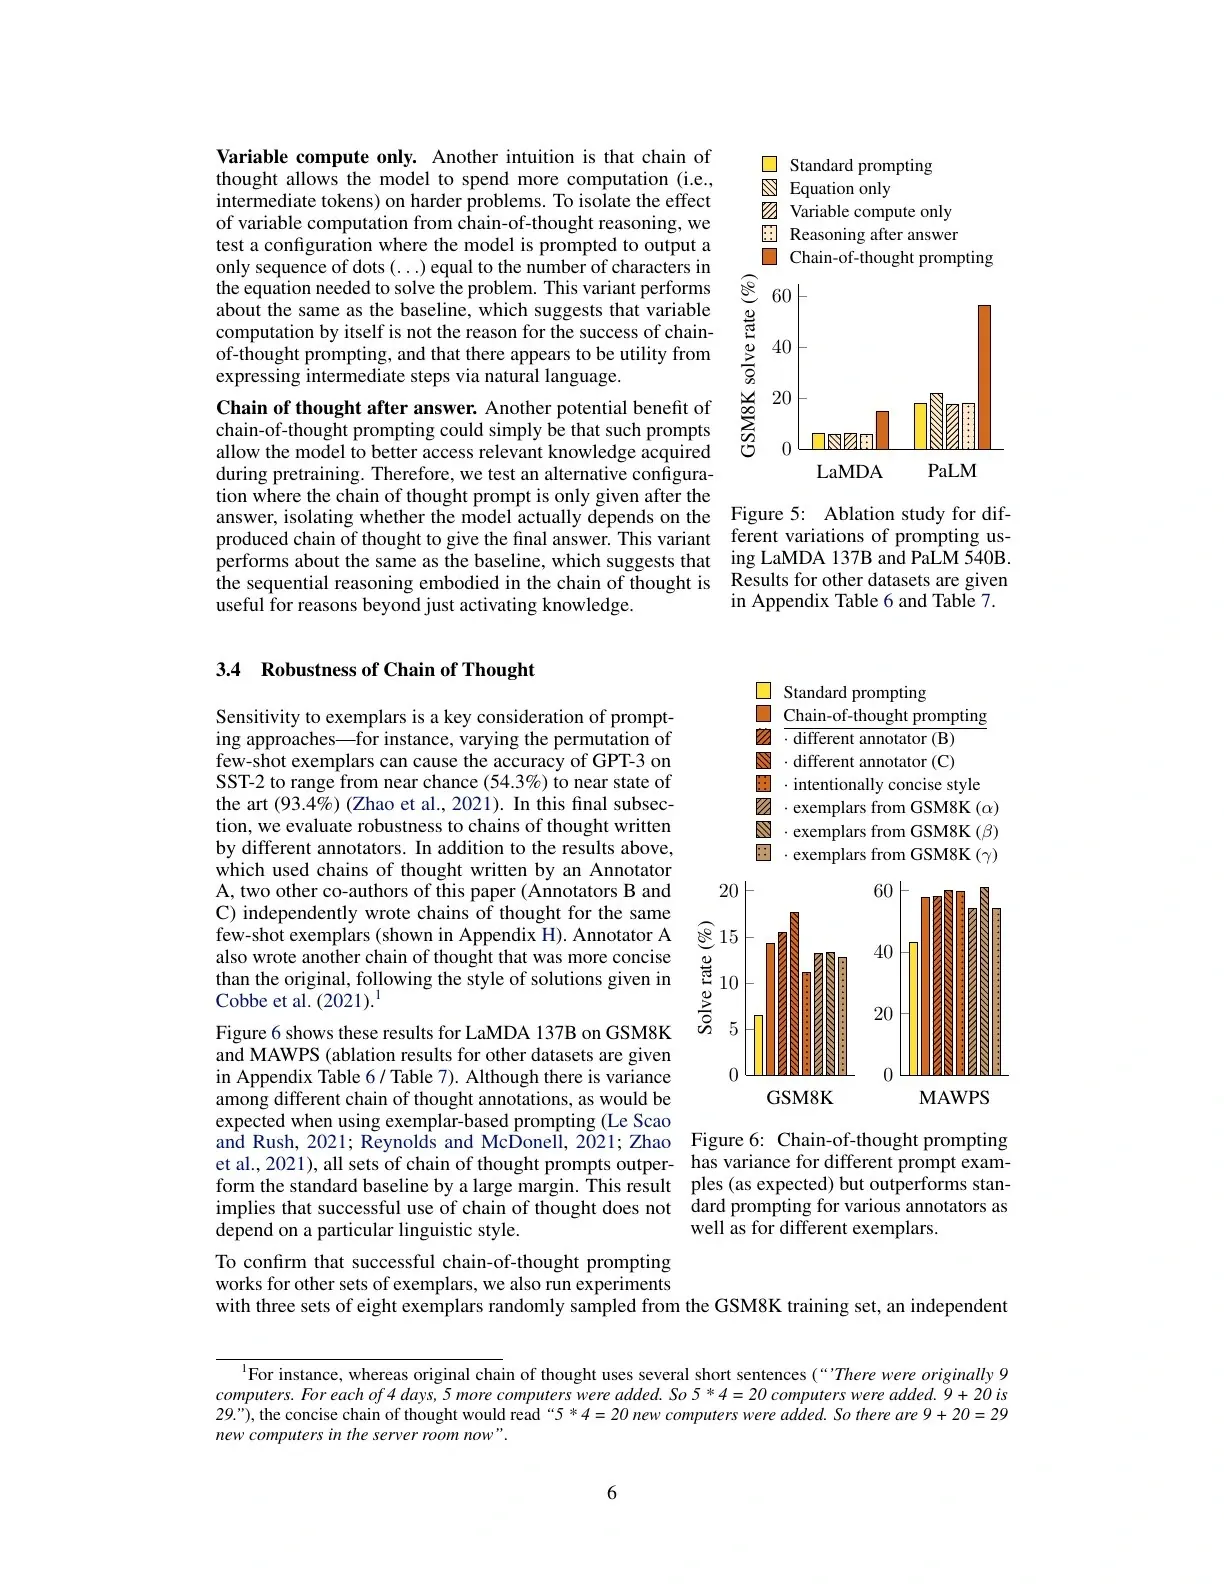
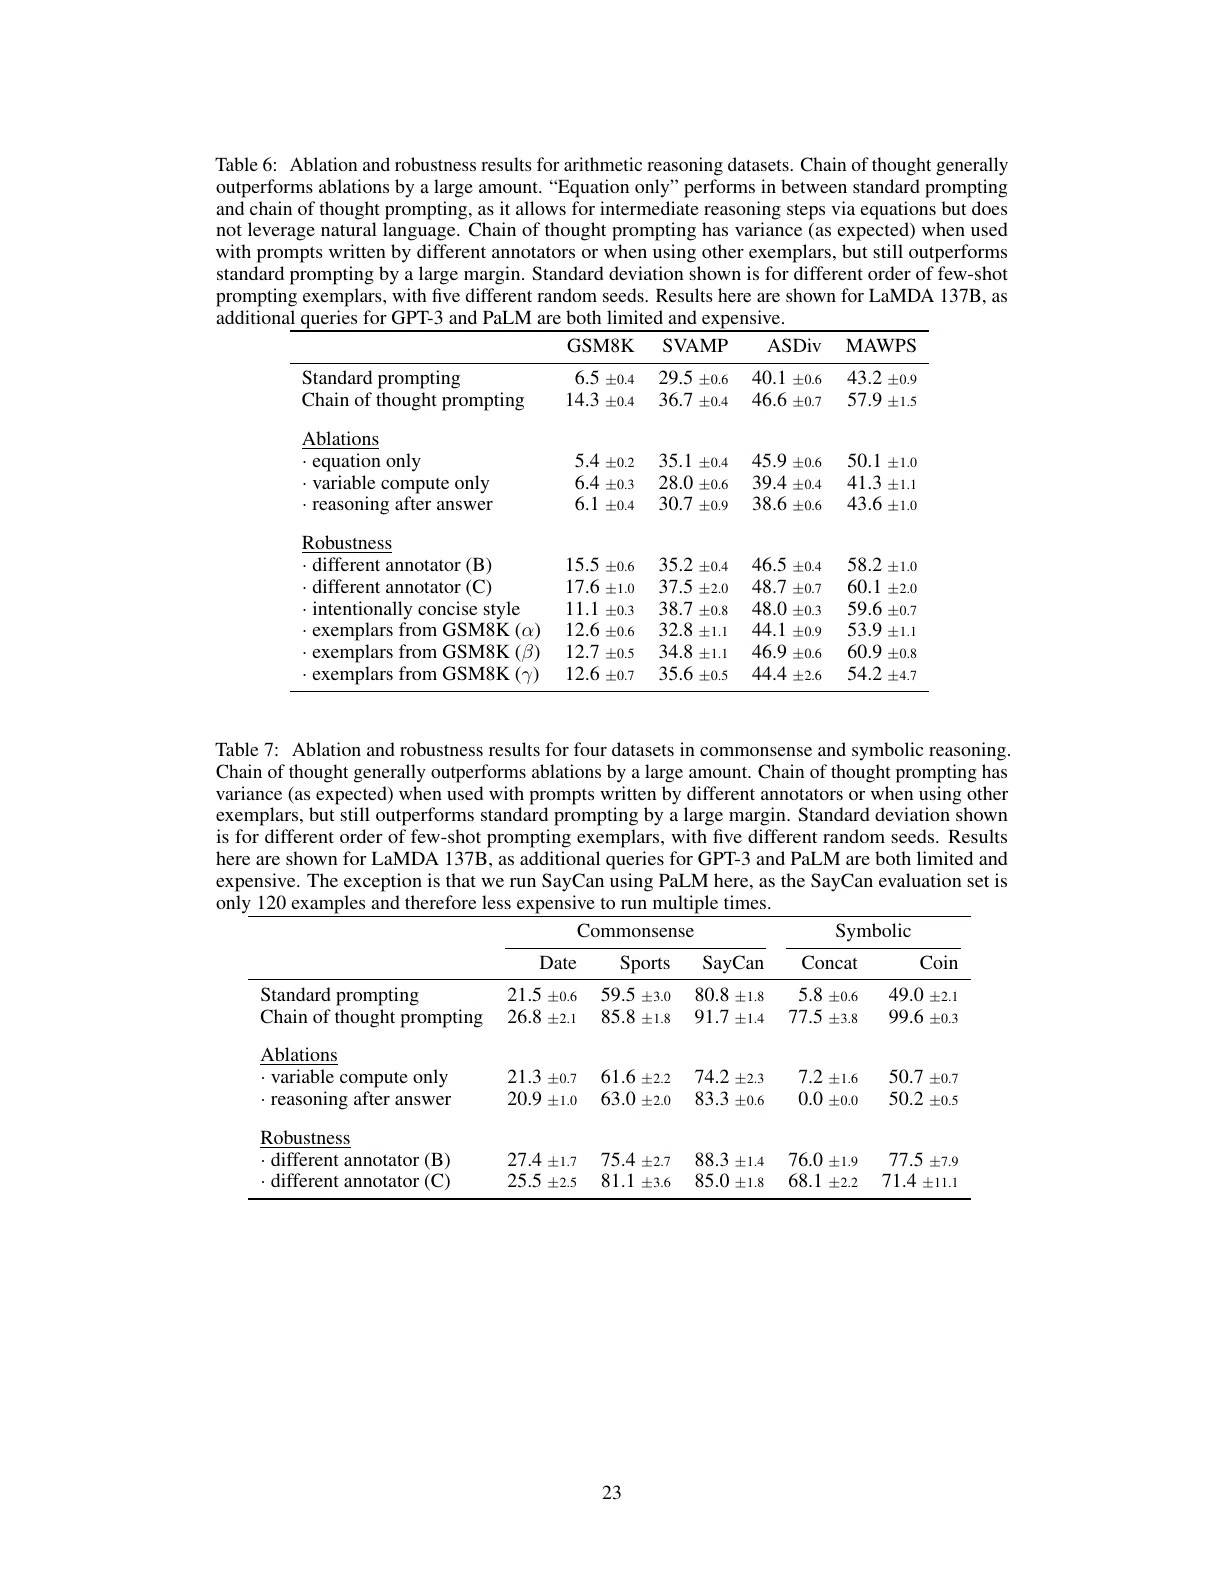
消融实验(验证 CoT 为什么有效)
| 变体 | 效果 | 结论 |
|---|---|---|
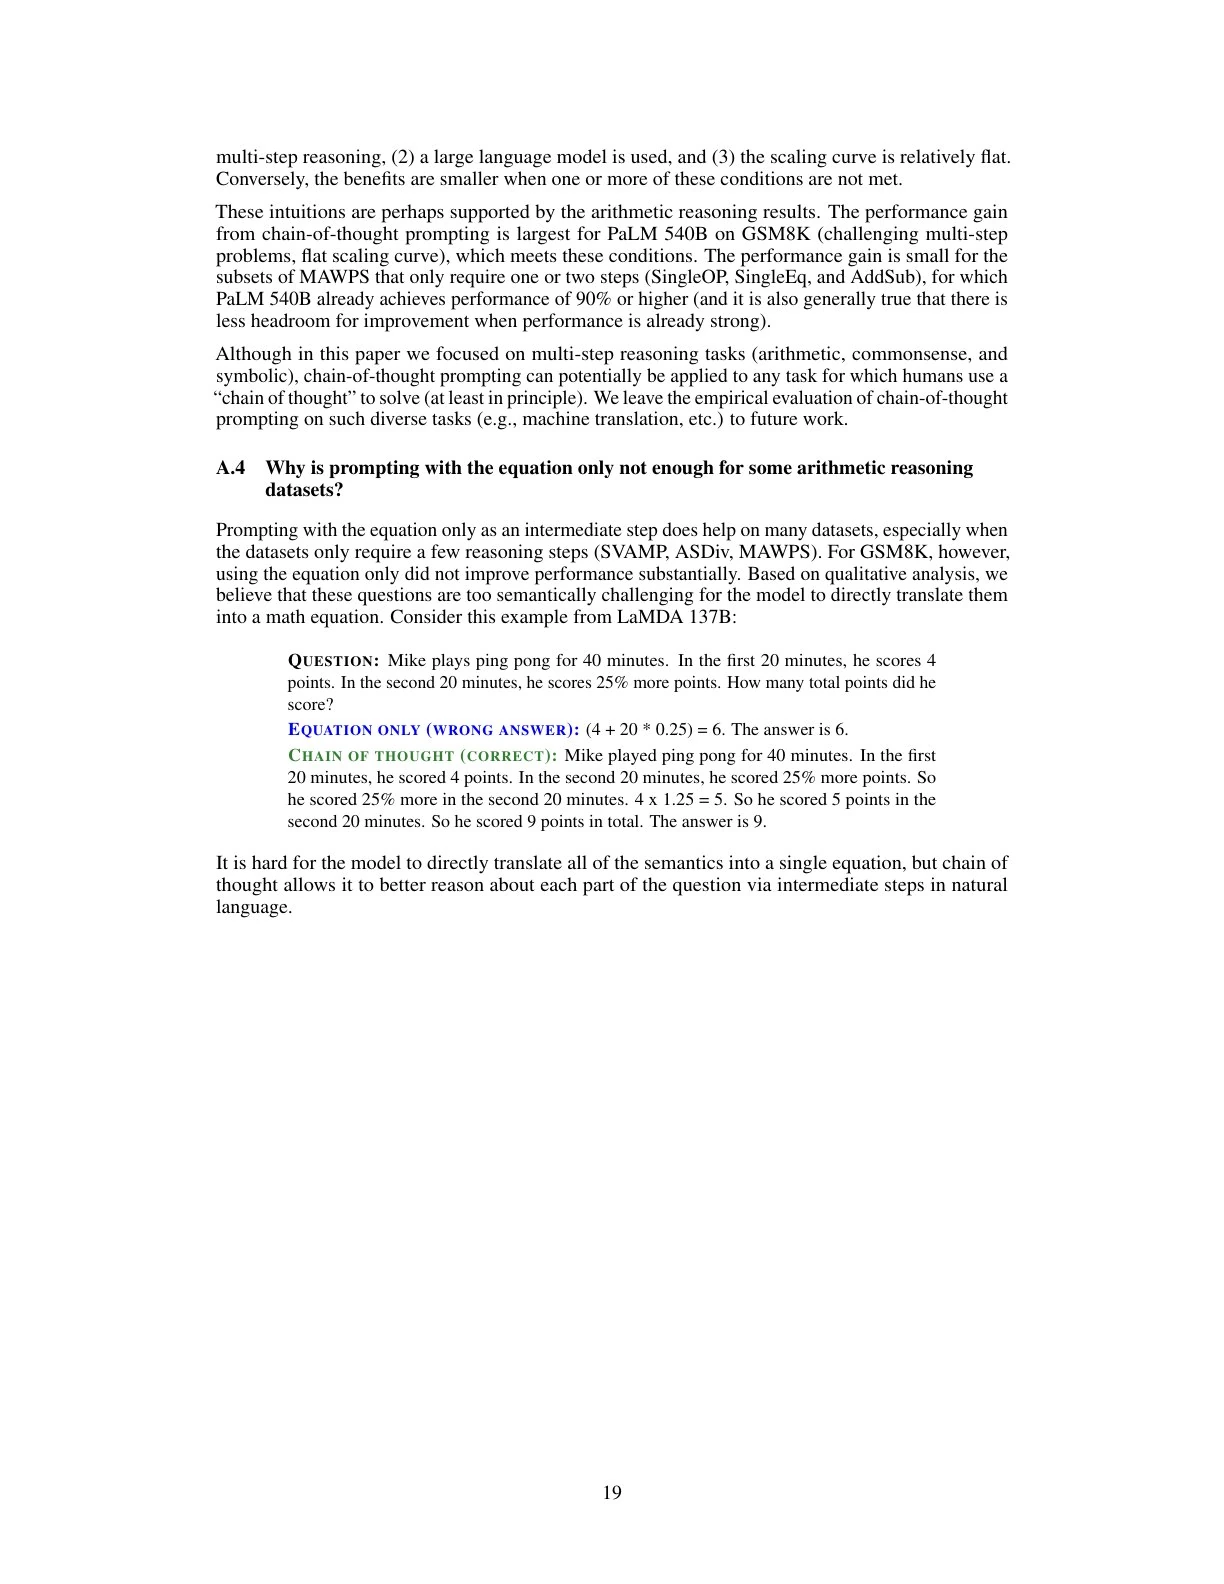
| 仅方程(equation only) | 略好于标准,远低于 CoT | 语义理解也很关键,不能只靠数学符号 |
| 仅输出等长度点(…) | 与标准相当 | “额外计算”本身不是收益来源 |
| 答案后给出推理 | 与标准相当 | 模型确实需要按顺序生成推理来得到答案 |
鲁棒性
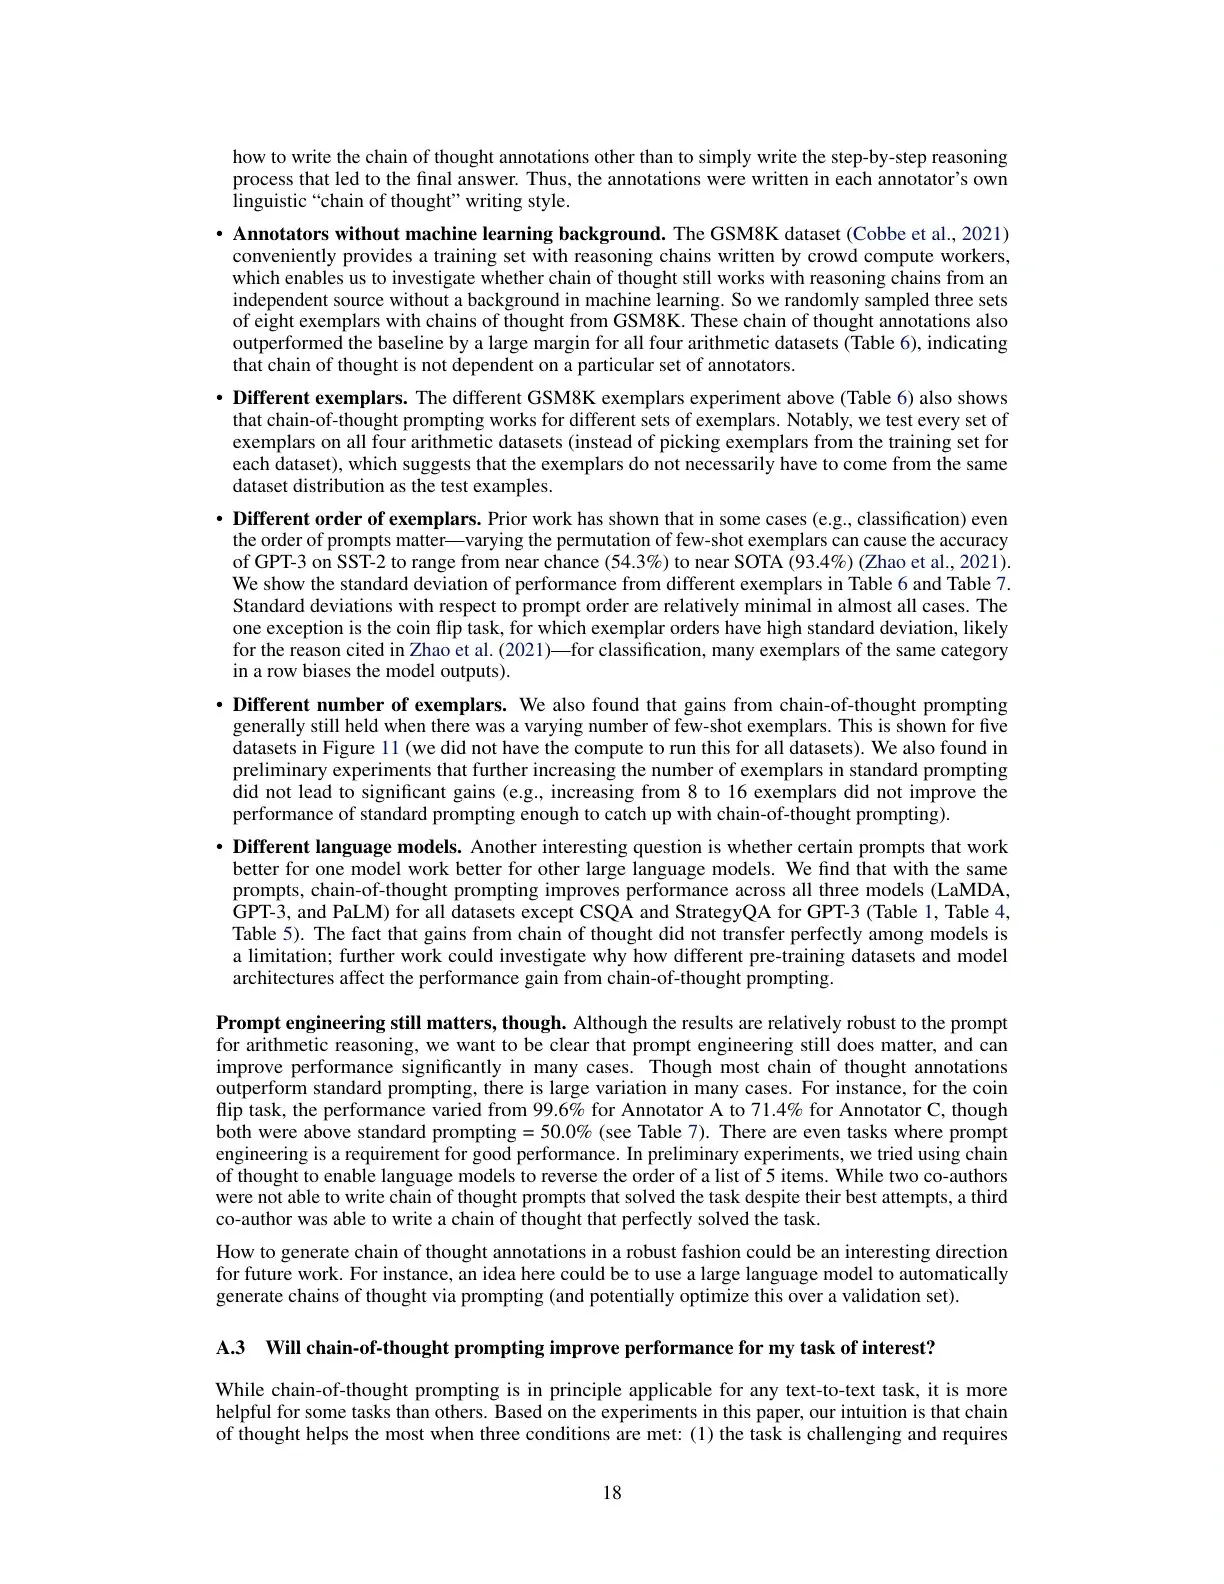
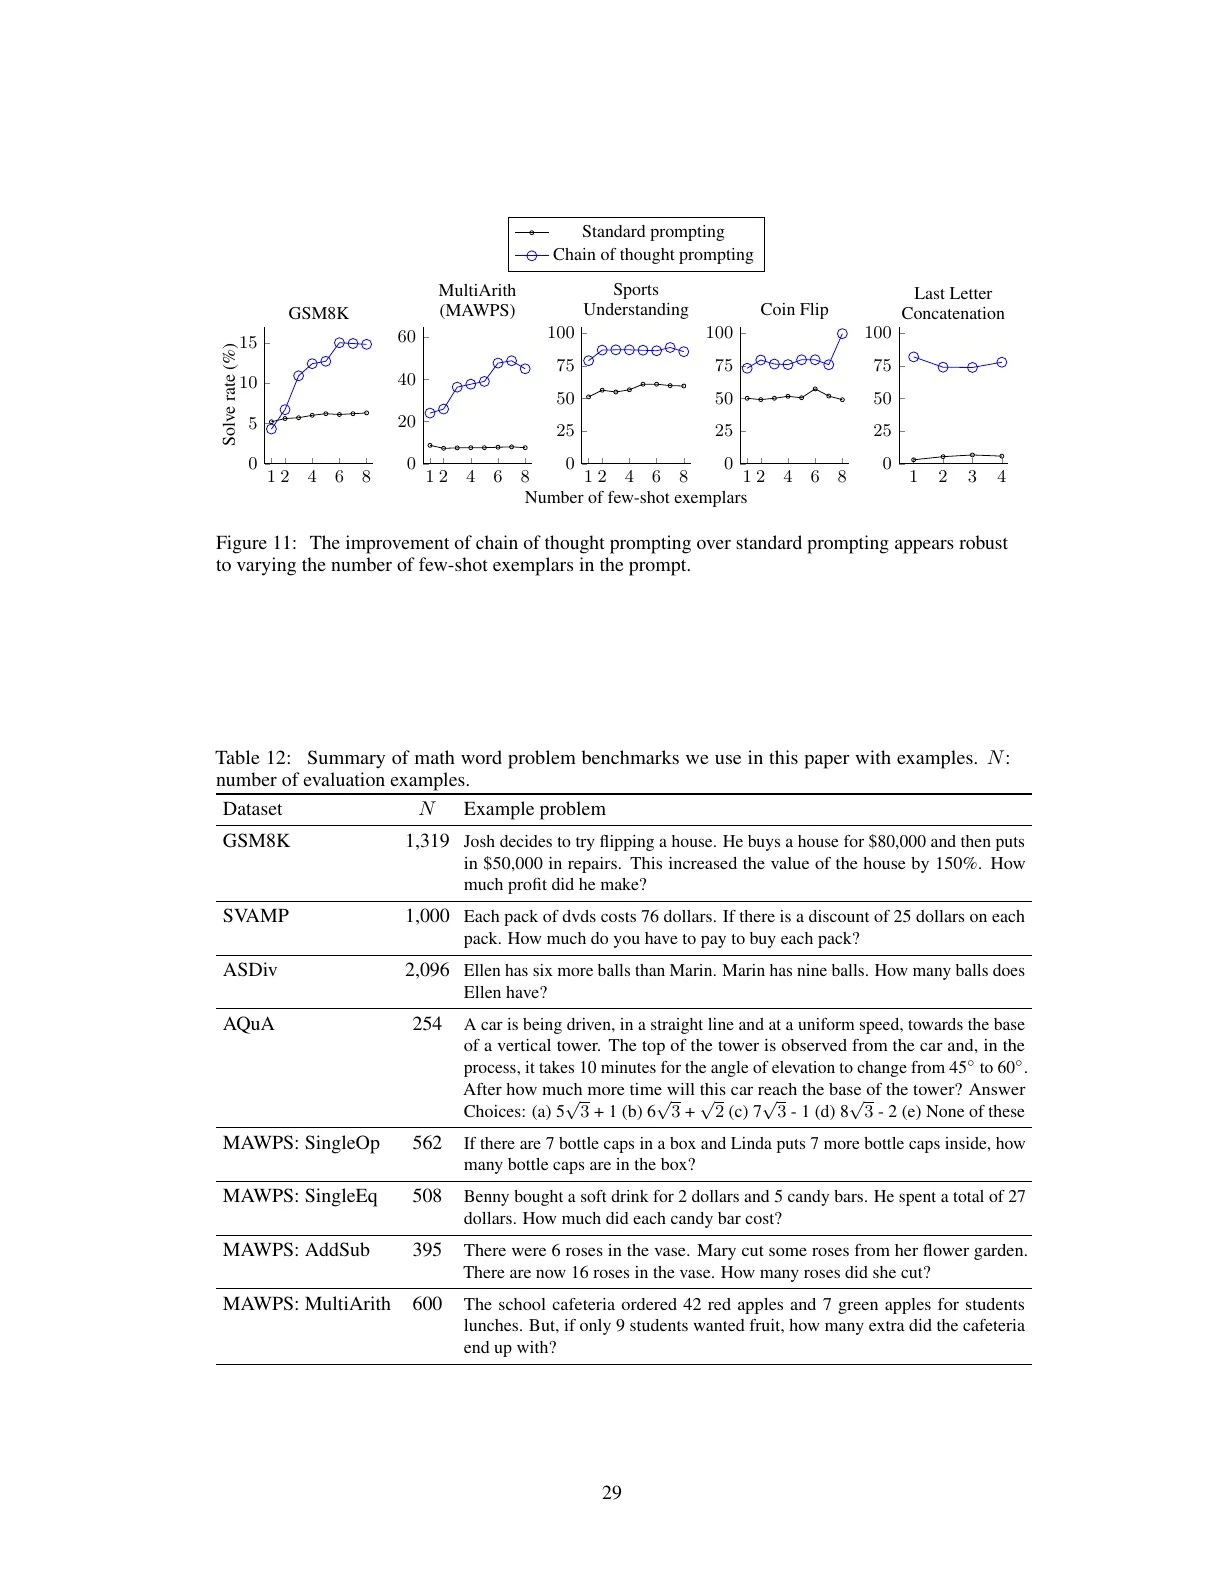
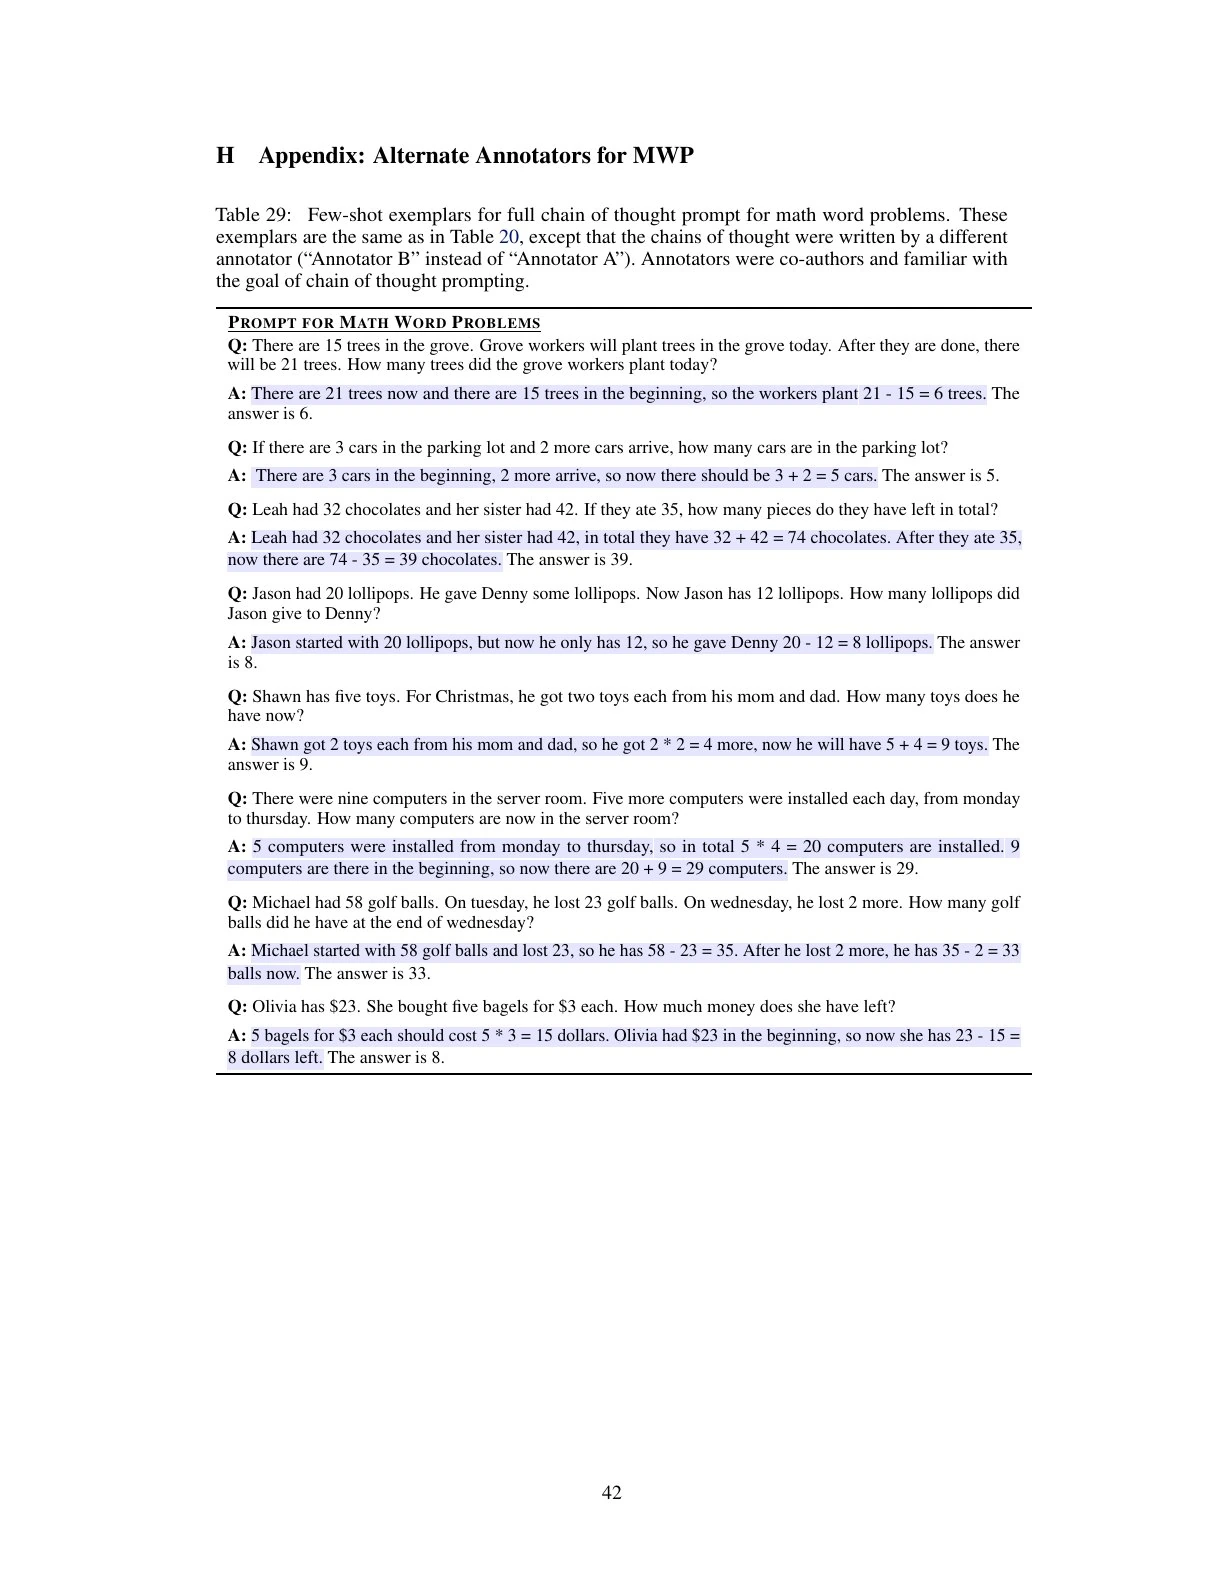
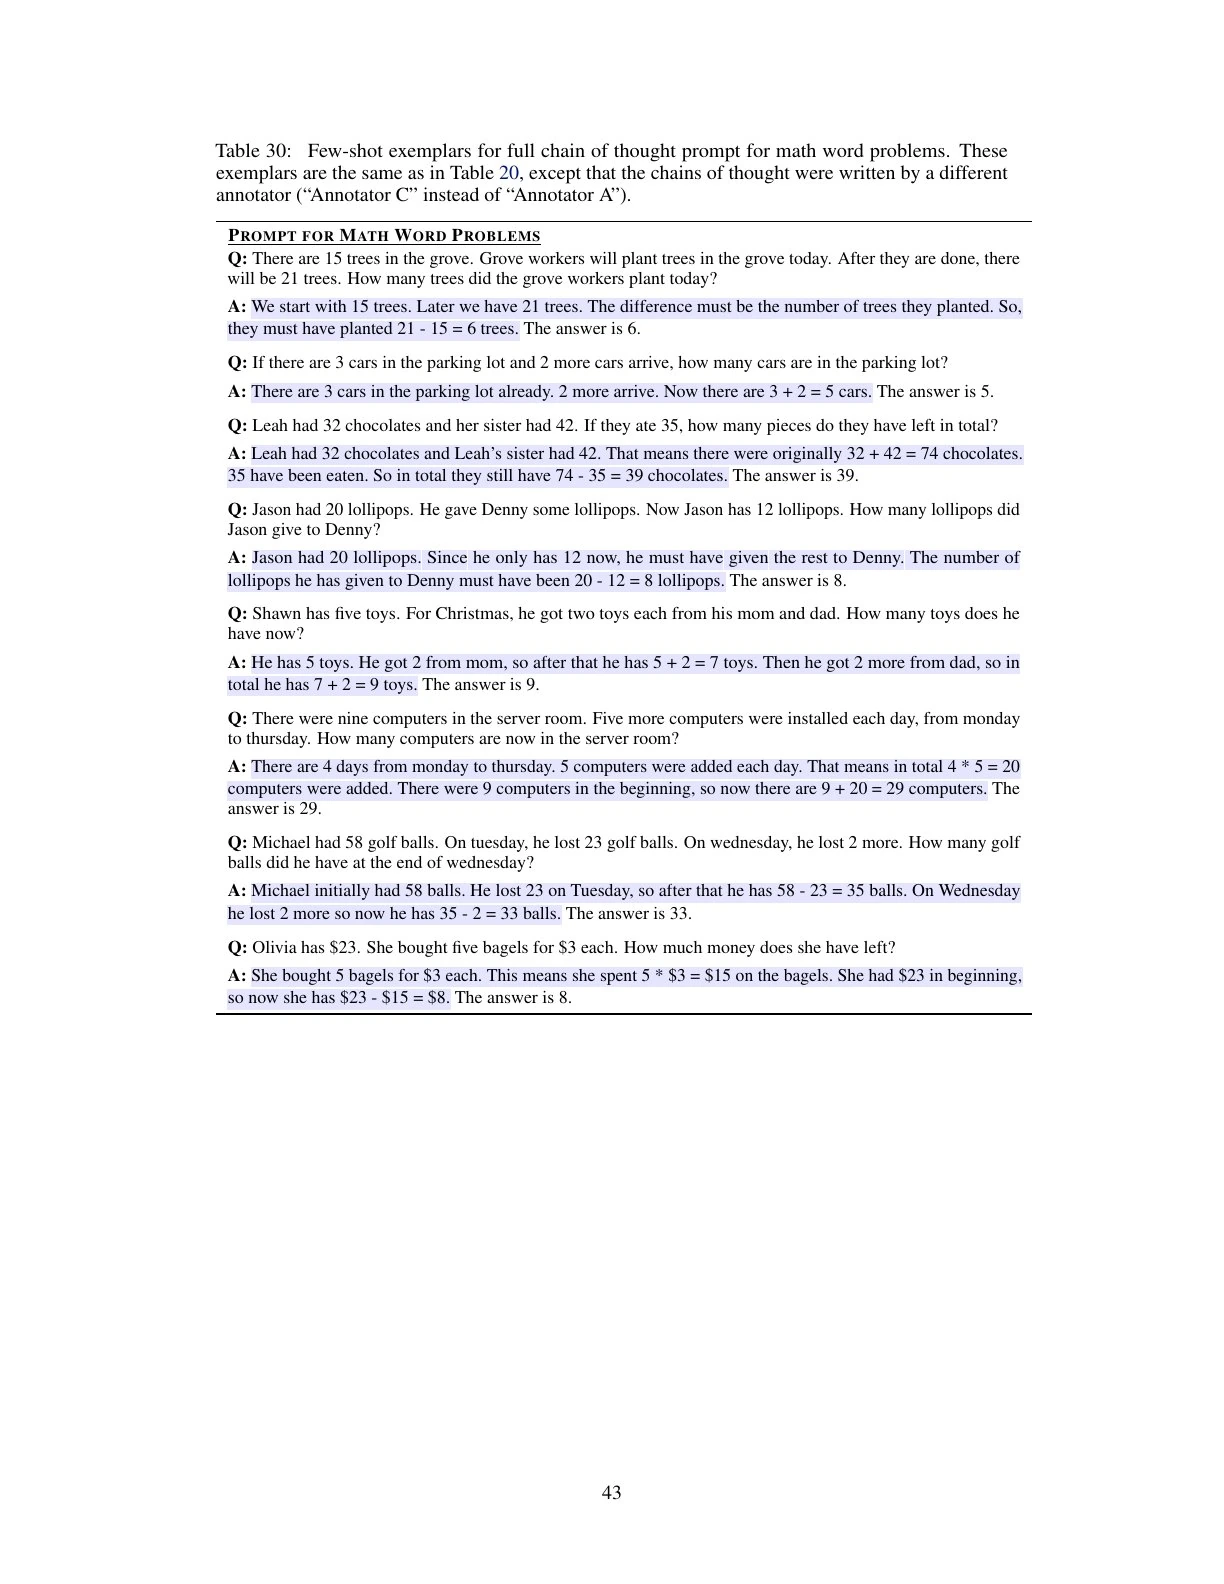
- 不同标注者:3 位标注者写的 CoT 都显著优于标准提示(虽有方差)。
- 不同示例集:从 GSM8K 训练集随机抽取的 3 组示例同样有效。
- 不同提示顺序:对算术任务影响小(分类任务如 coin flip 影响略大)。
- 不同模型:CoT 在 GPT-3、LaMDA、PaLM 上都有效(需足够大)。
5. 优点与局限性
优点
- 极简实现:只需在 prompt 中加入少量推理示例,无需训练或微调。
- 适用范围广:已在数学、常识、符号推理上验证,原则上可用于任何语言可描述的任务。
- 揭示模型潜力:标准提示只展现了 LLM 能力的“下限”,CoT 提供了更高上限。
- 可解释性:推理过程可读,便于理解模型行为。
局限性
- 仅在大模型上涌现:< 100B 的模型难以受益,甚至受损,限制了在资源受限场景的应用。
- 无正确性保证:模型可能生成看似合理但错误或不合逻辑的推理链。
- 标注成本:虽然 few-shot 成本可控,但大规模微调仍需大量标注推理数据。
- 不适用于所有任务:对不需要多步推理的简单任务(如单步运算)增益很小或为负。
6. 核心贡献总结
- 首次系统性地证明了 “让模型生成中间推理步骤” 这种简单方法能够极大提升 LLM 的多步推理能力。
- 揭示了 CoT 是一种“涌现能力”,只在模型规模达到约 100B 参数时才显著出现。
- 在 GSM8K 上首次仅靠 prompting 超越微调 SOTA,开创了“用推理过程激发潜能”这一研究方向。
- 为后续工作(Self-Consistency, ToT, Reflexion)奠定了 概念和技术基础 ——所有后续方法都是在 CoT 之上增加多样性、搜索或反馈机制。
原论文在线预览
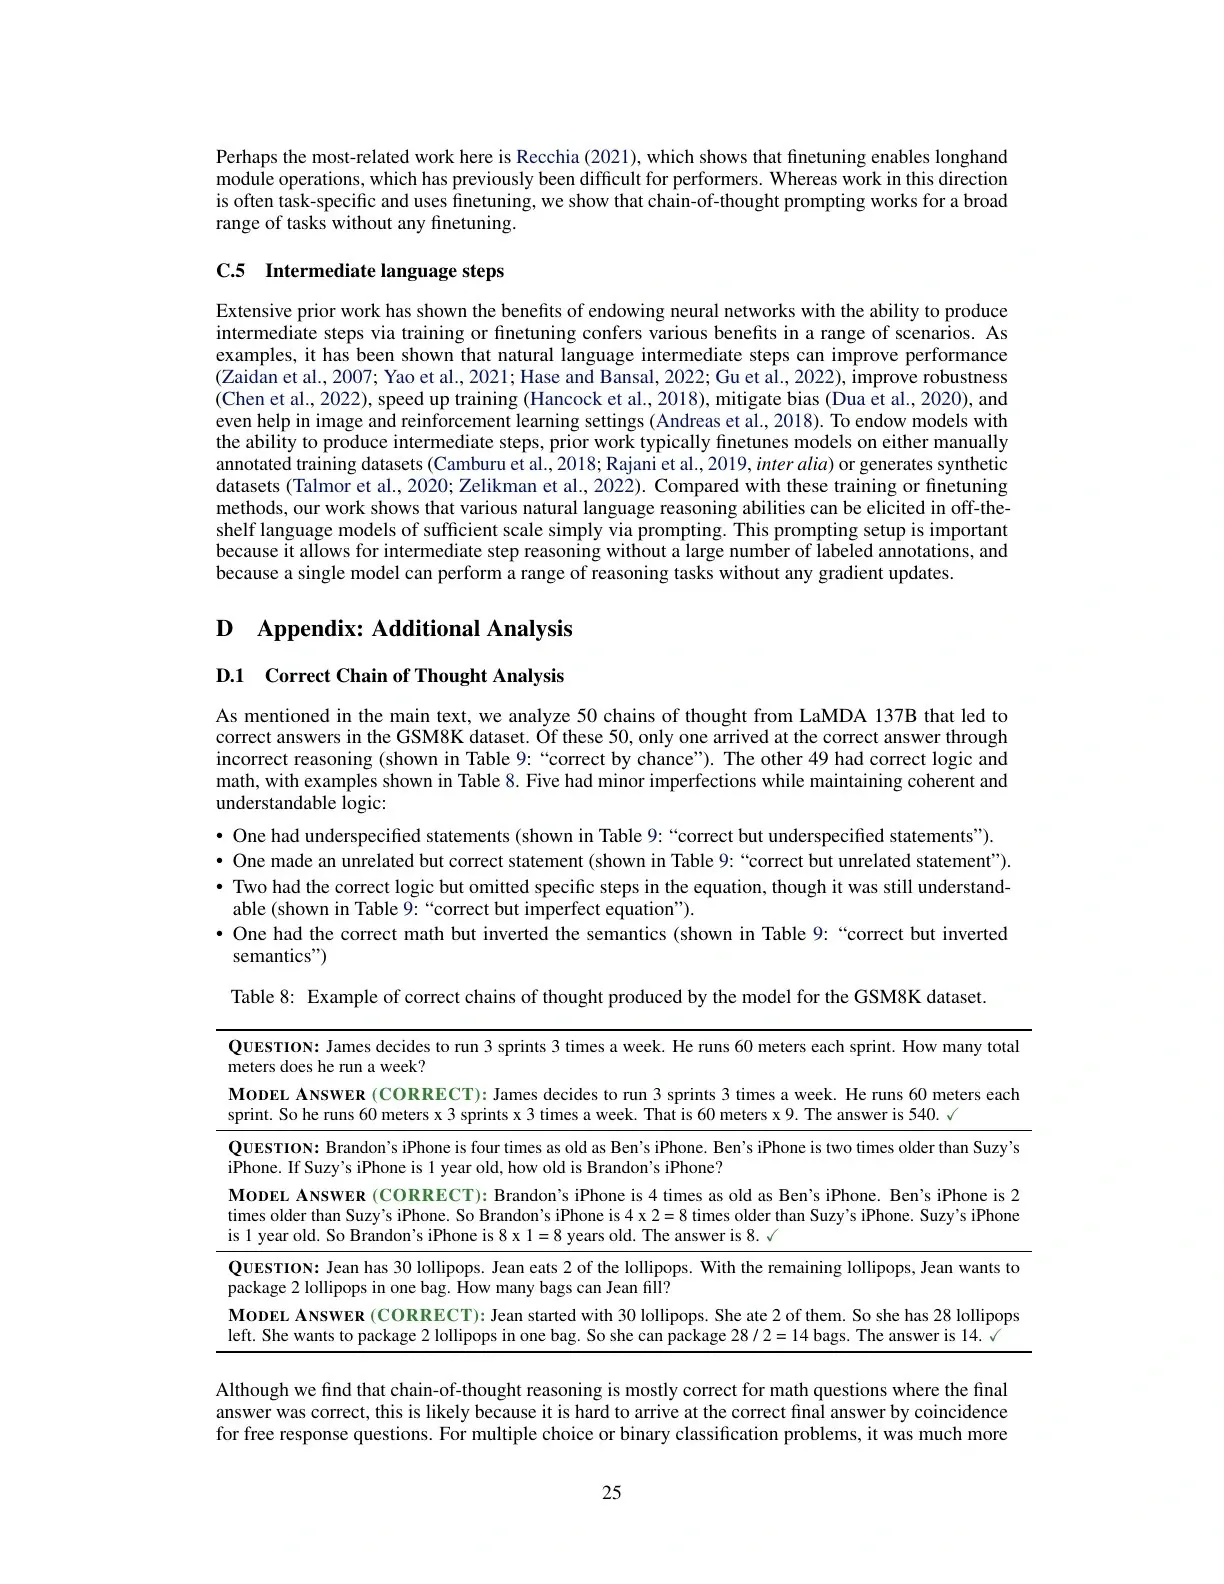
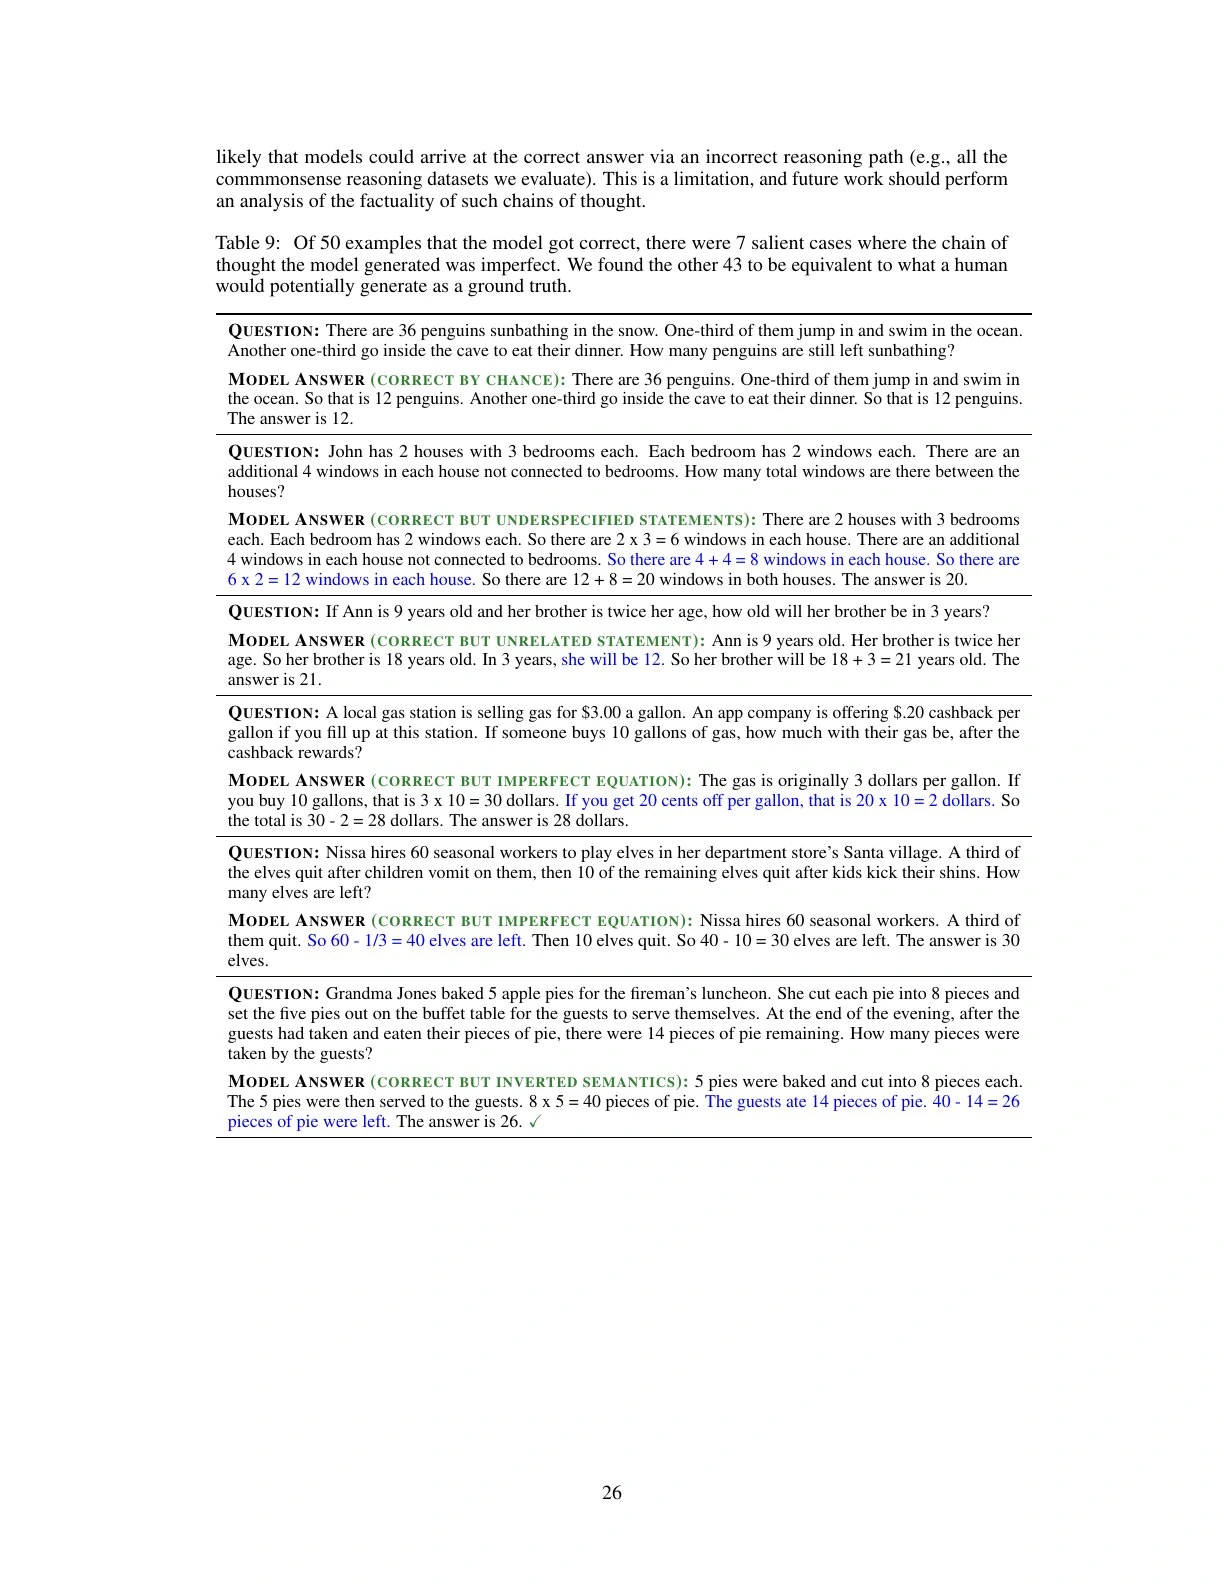
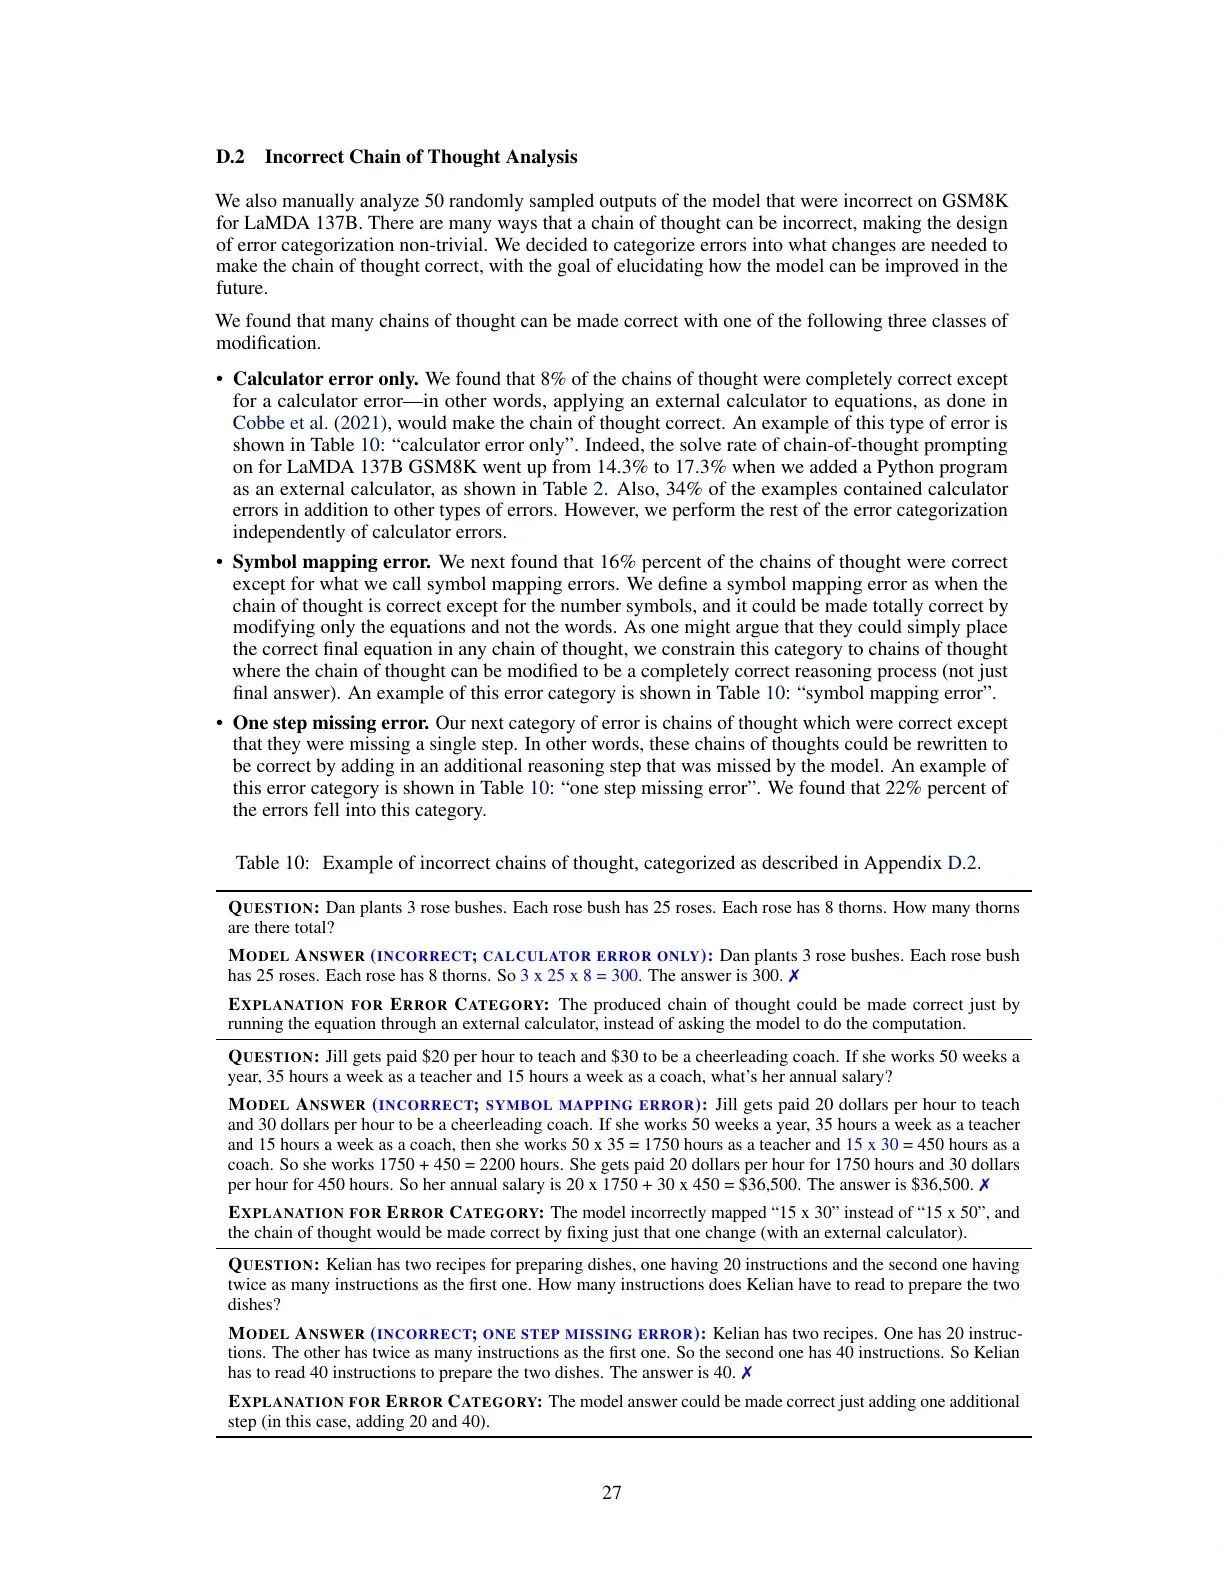
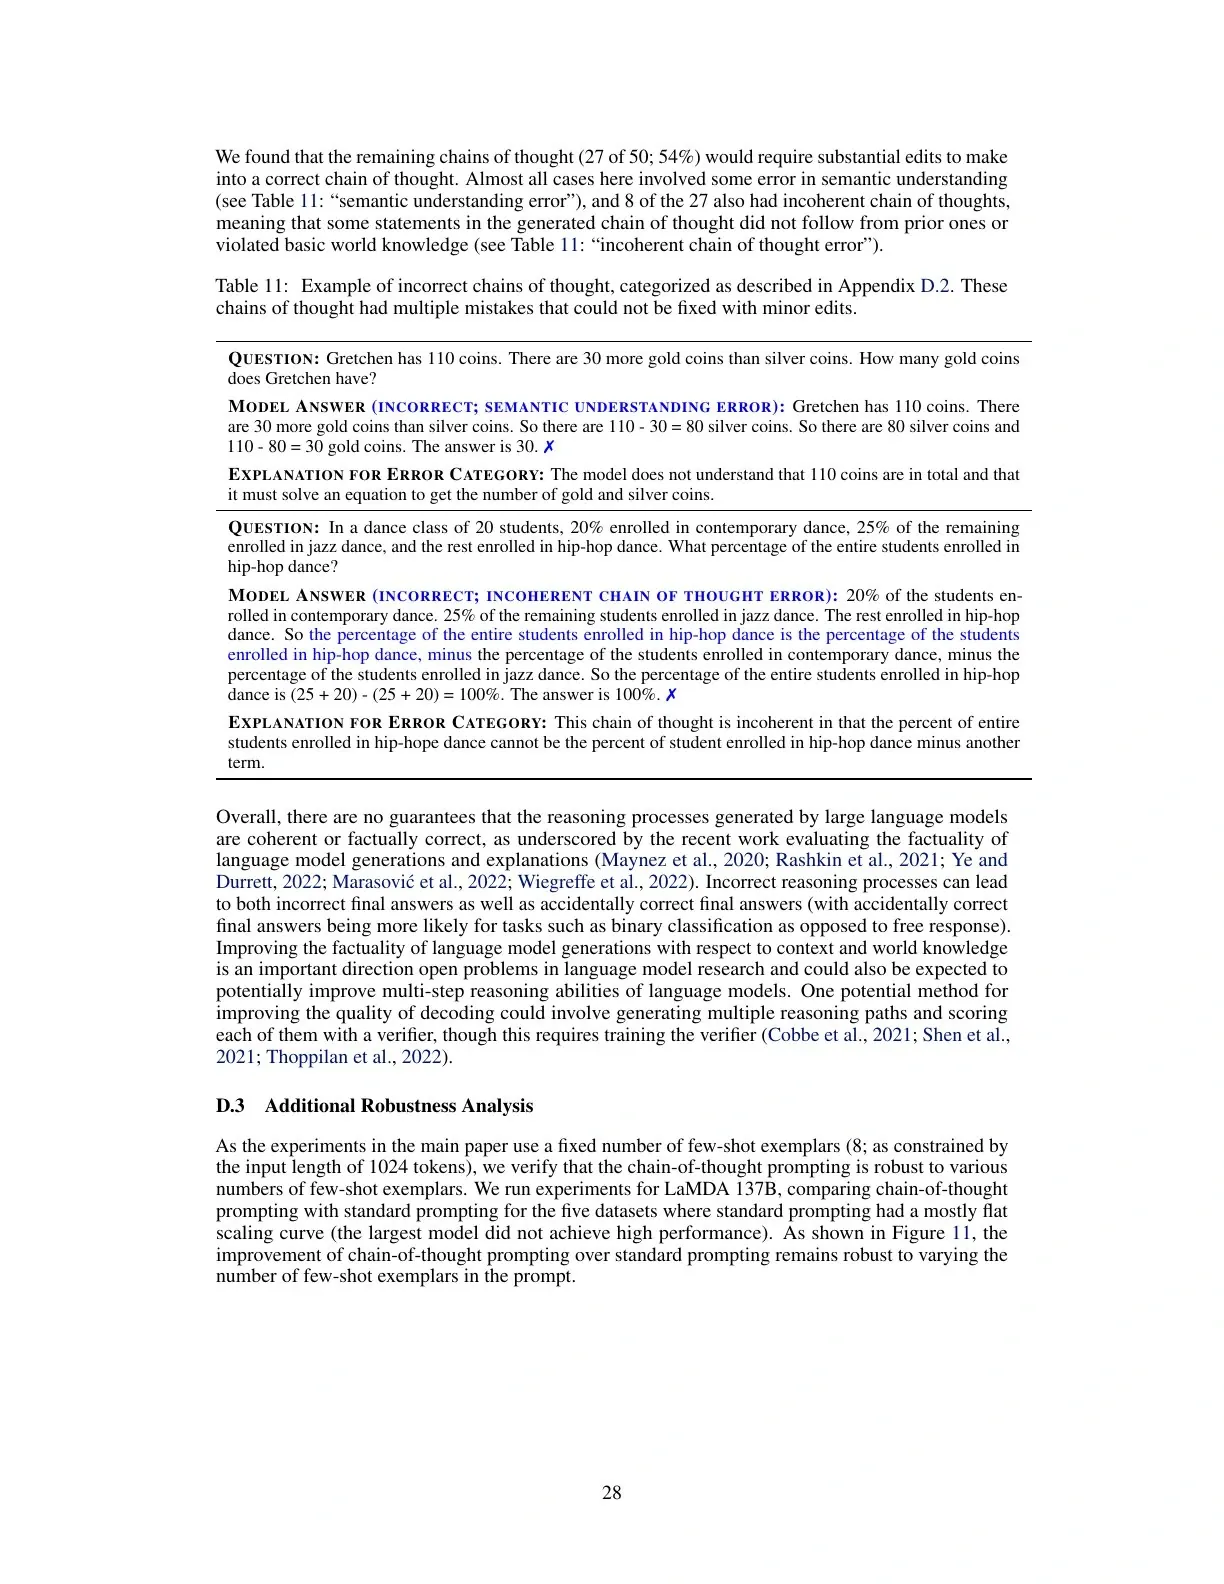
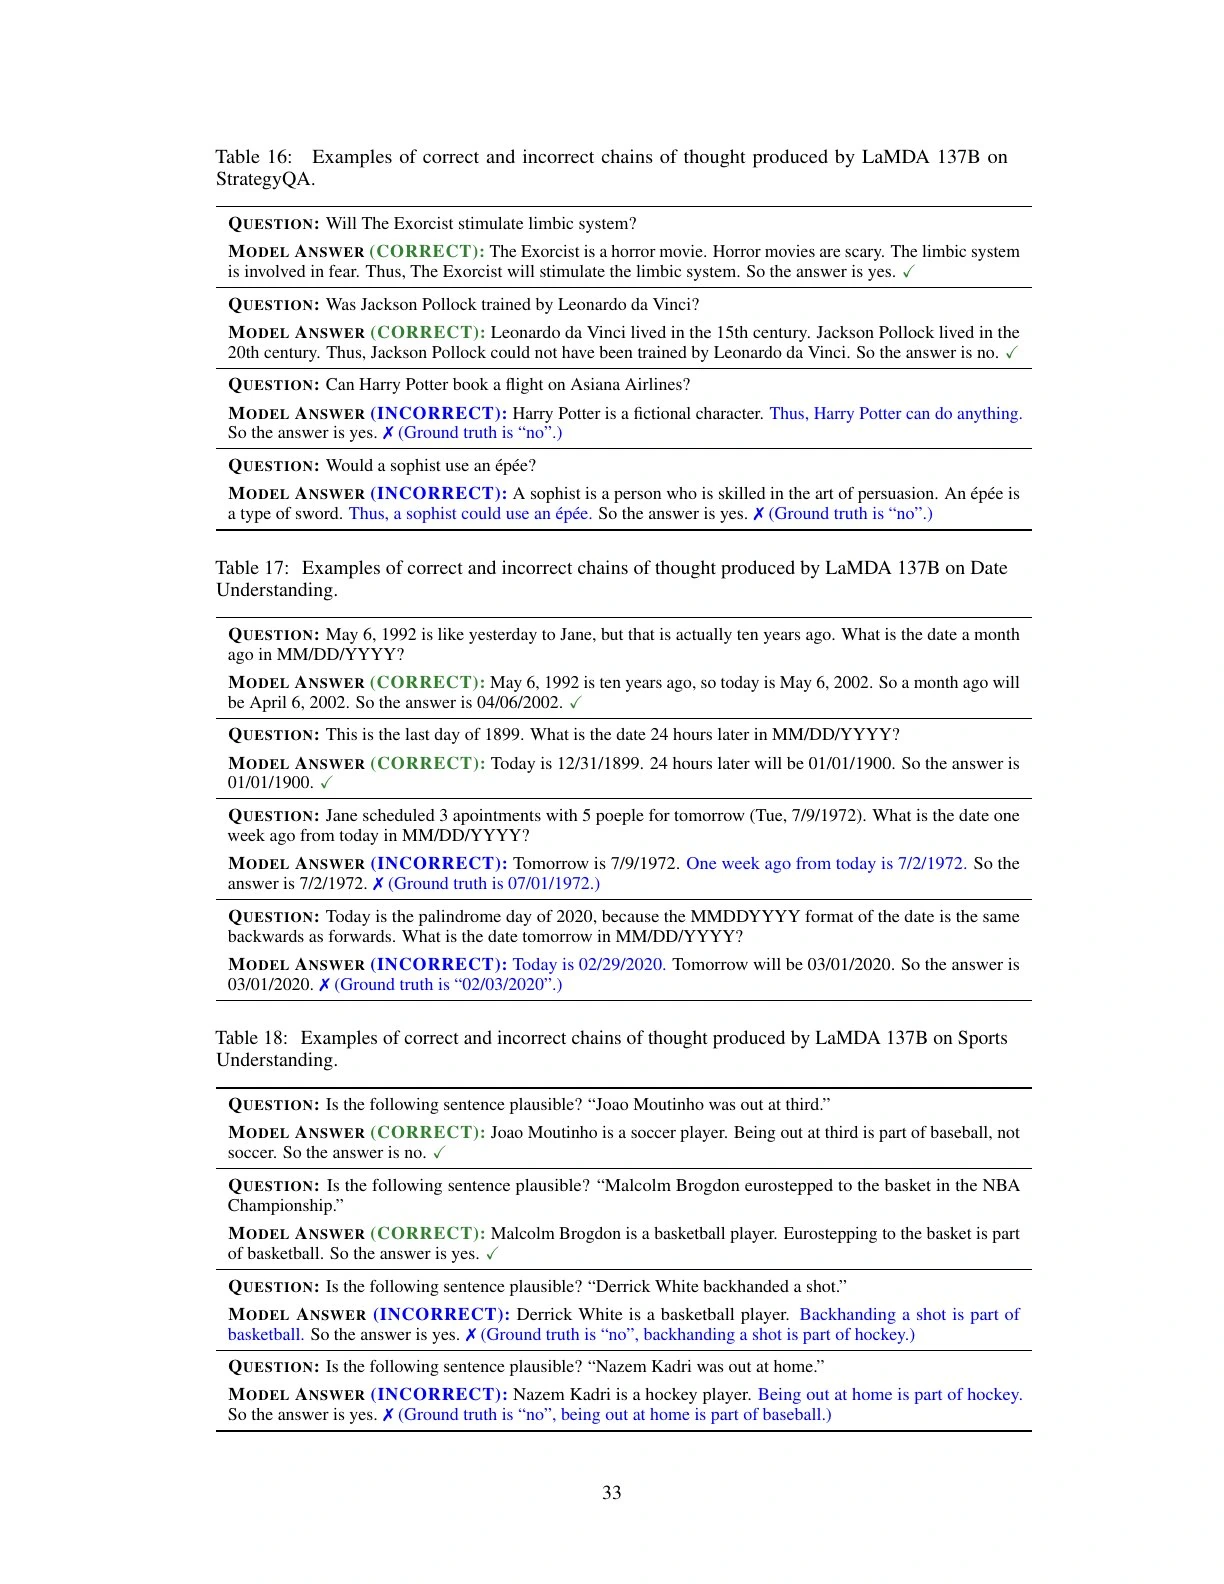
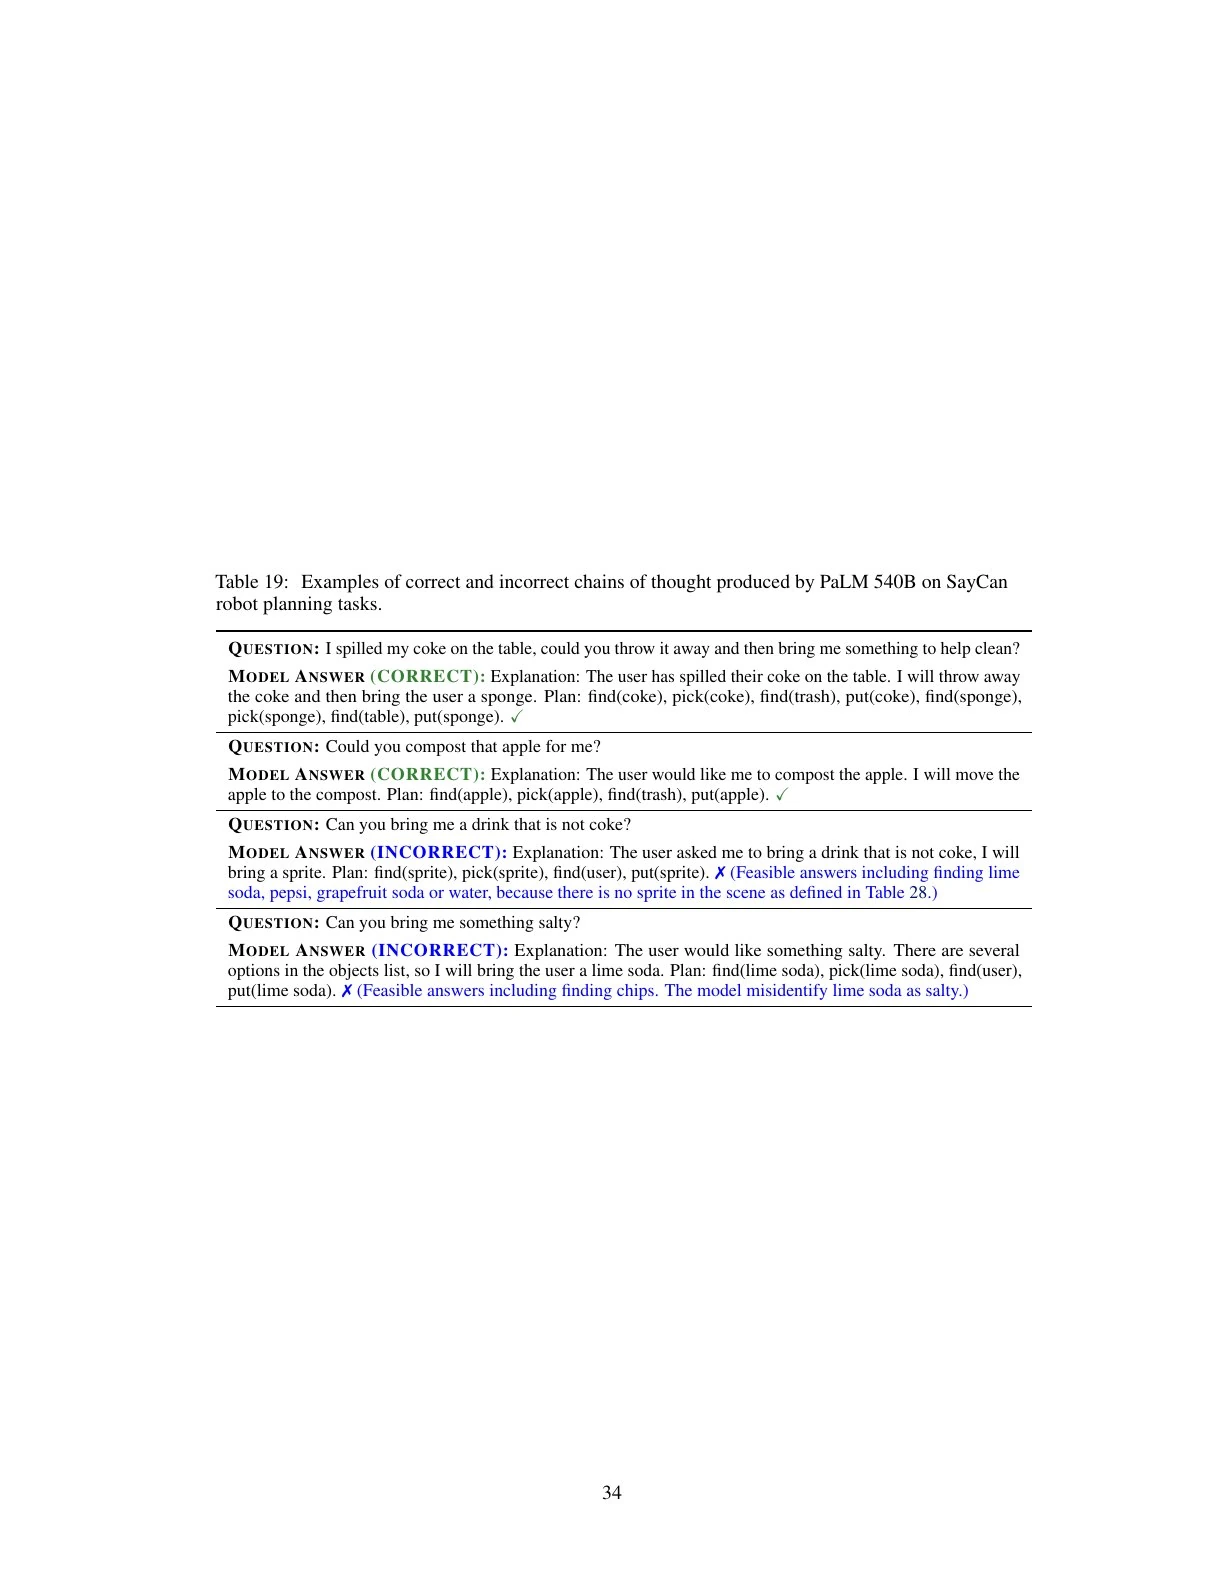
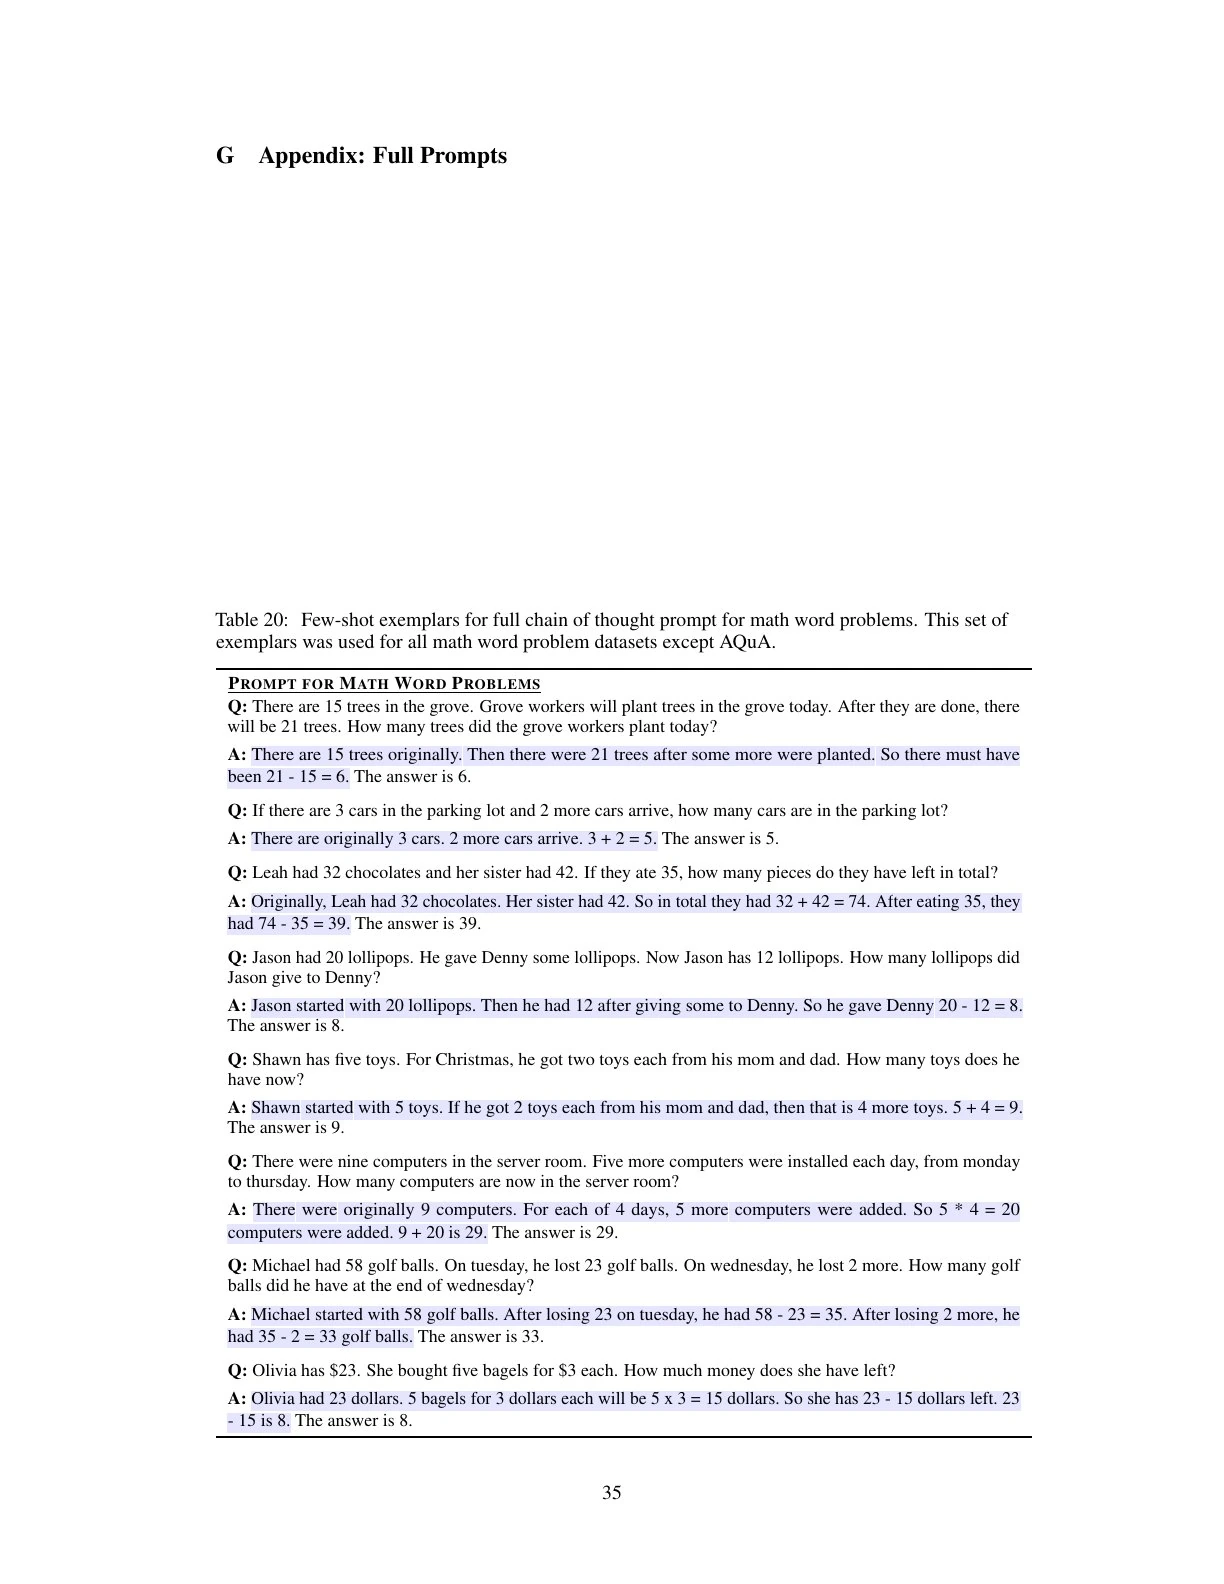
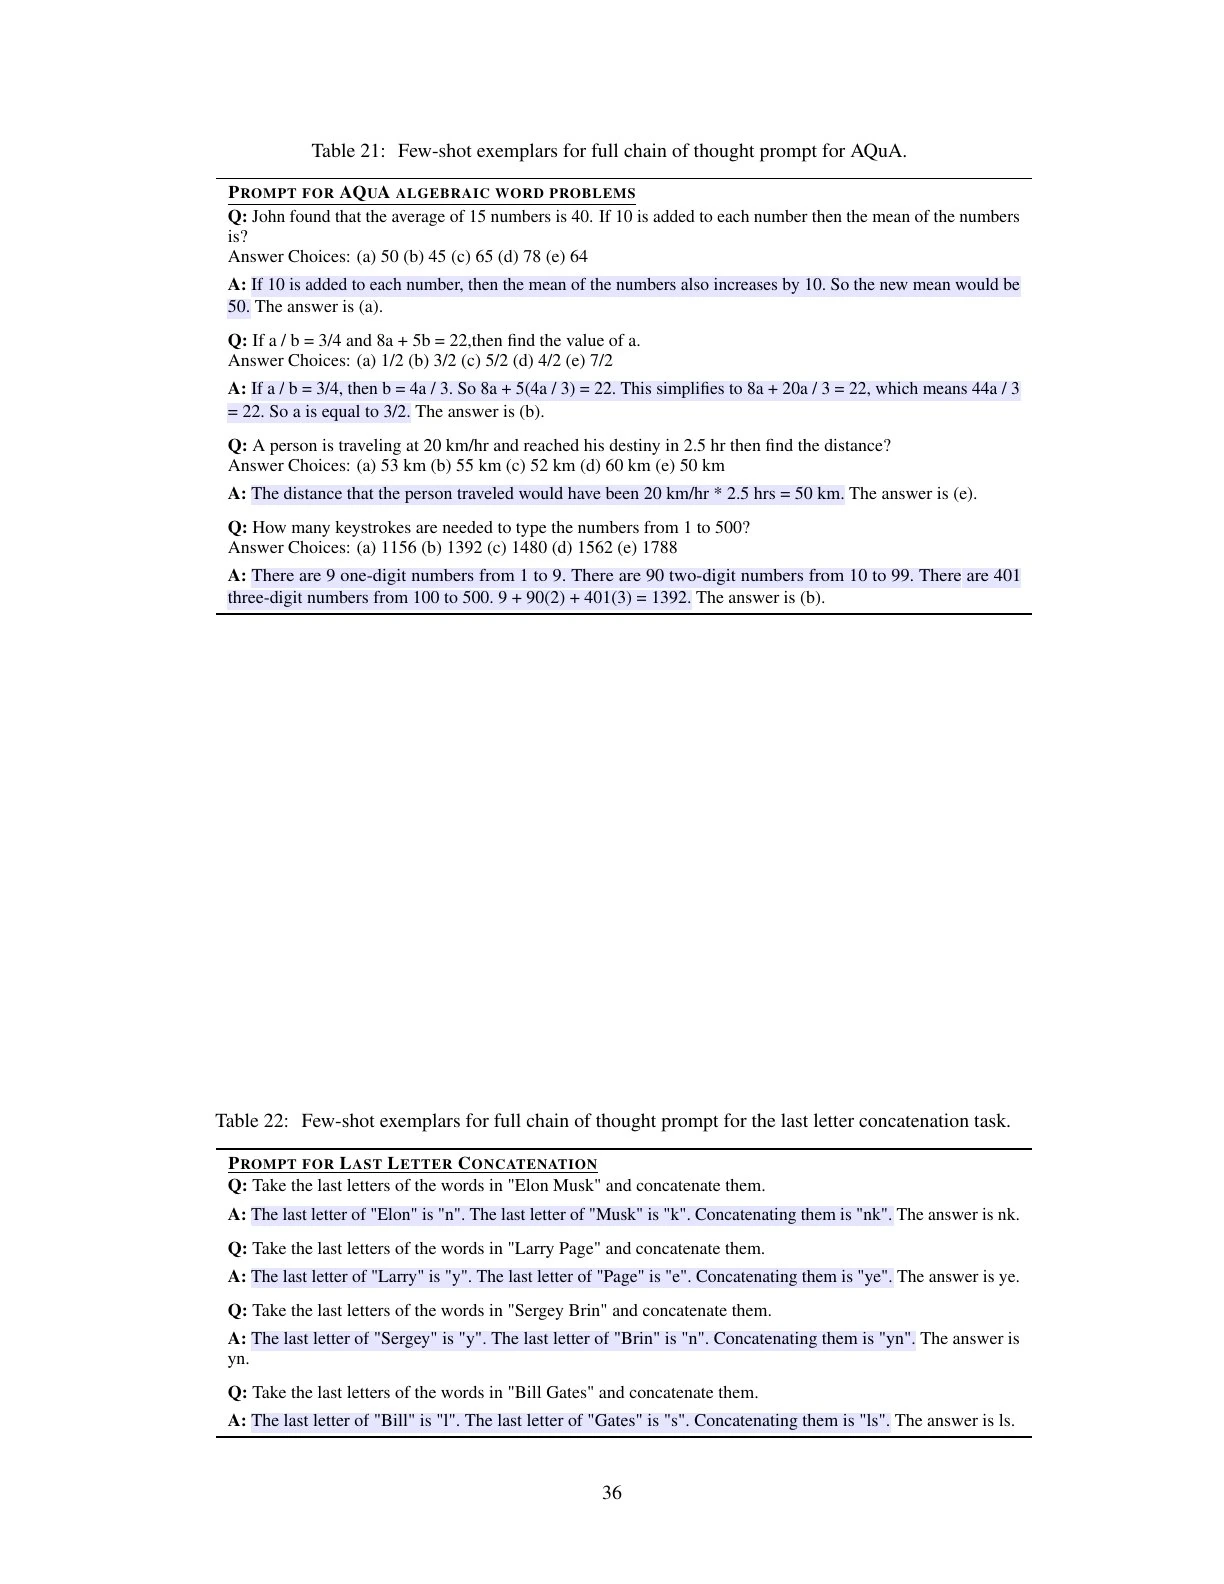
文章分享
如果这篇文章对你有帮助,欢迎分享给更多人!
CoT思维链
https://www.shanfengpm.com/posts/2026-02-24-paper-chain-of-thought/本文首发于「山风blog」,作者:山风(余涛)。欢迎转发、分享本文链接, 但禁止任何形式的未授权转载、摘编、改写或商业使用。

推荐文章论文阅读
1
TOT思维树
笔记提炼 Tree of Thoughts 思维树的搜索机制、实验结果与适用边界,并附原论文在线预览。
2
自我一致性
笔记提炼 Self-Consistency 自我一致性方法的核心问题、采样投票机制、实验结果与适用边界,并附原论文在线预览。
3
反思机制
笔记提炼 Reflexion 言语强化学习的核心方法、实验结果与适用边界,并附原论文在线预览。
4
大模型认知基础
笔记大模型认知基础课程资料,涵盖 AI、机器学习、深度学习、大模型、RAG、Agent 与微调。
5
AI基础小测
笔记复盘 AI、Token、Transformer、幻觉、Embedding 与多模态能力,检验 AI 产品判断的基础框架。